今天要解的問題
昨天提到的四個專案裡,Art-Tracking 是最熱騰騰的那個,之前有個劃了一個圈,但那個圈關不起來。
它要解的是一個很個人的問題:喜歡逛展的我,每次要查詢都覺得很麻煩,沒有一個專屬於我個人操作習慣的網站,因此常想要自己做。將散在各館官網和 IG 的台北展覽資訊,通通抓起來,然後用我的方式呈現。之前的第一版用程式爬蟲抓,但畫廊網頁一改版就斷,修爬蟲的時間比看展還多,還套用了 github action,但一直失敗,後來就關掉,把網站也捨棄了。
第二版動工前,先把「這個工具到底要長什麼樣」想清楚。這篇記的是規劃階段和 Claude 來回討論後定下來的六個取捨,每一個都會講它落到程式上長什麼樣。
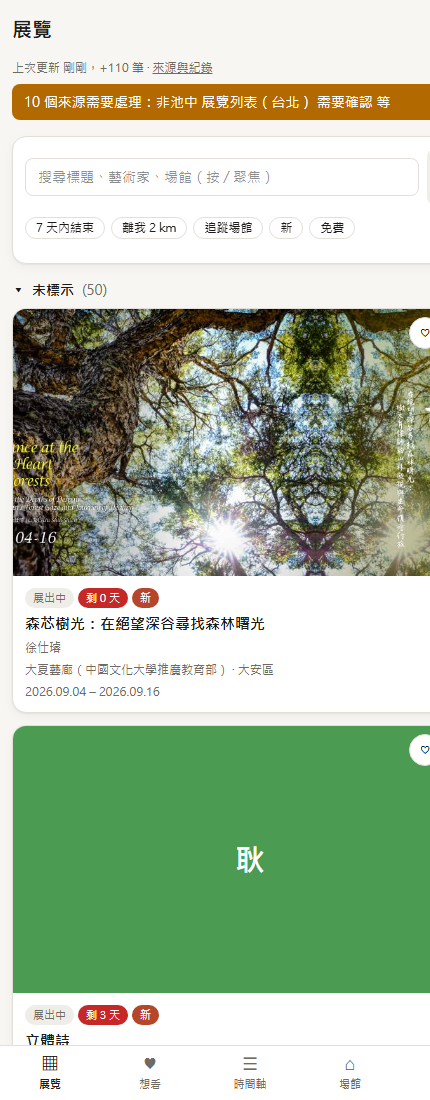
先看成品:首頁上方是搜尋和五個快捷 chip,卡片上有「展出中、剩 0 天、新」三種標記,右上角的愛心隨時可以按,也可以不按。目前網站是有鎖登入ㄉ
想法與取捨
一、抓資料交給 agent,不再寫爬蟲
每家畫廊網頁結構都不同,寫死選擇器注定要一直修。改成讓 Claude Code 的 skill 讀頁面、整理成 JSON 送進 API,網站改版它自己會找。代價是每次抓取要花 token,但一週跑一次,可以接受。
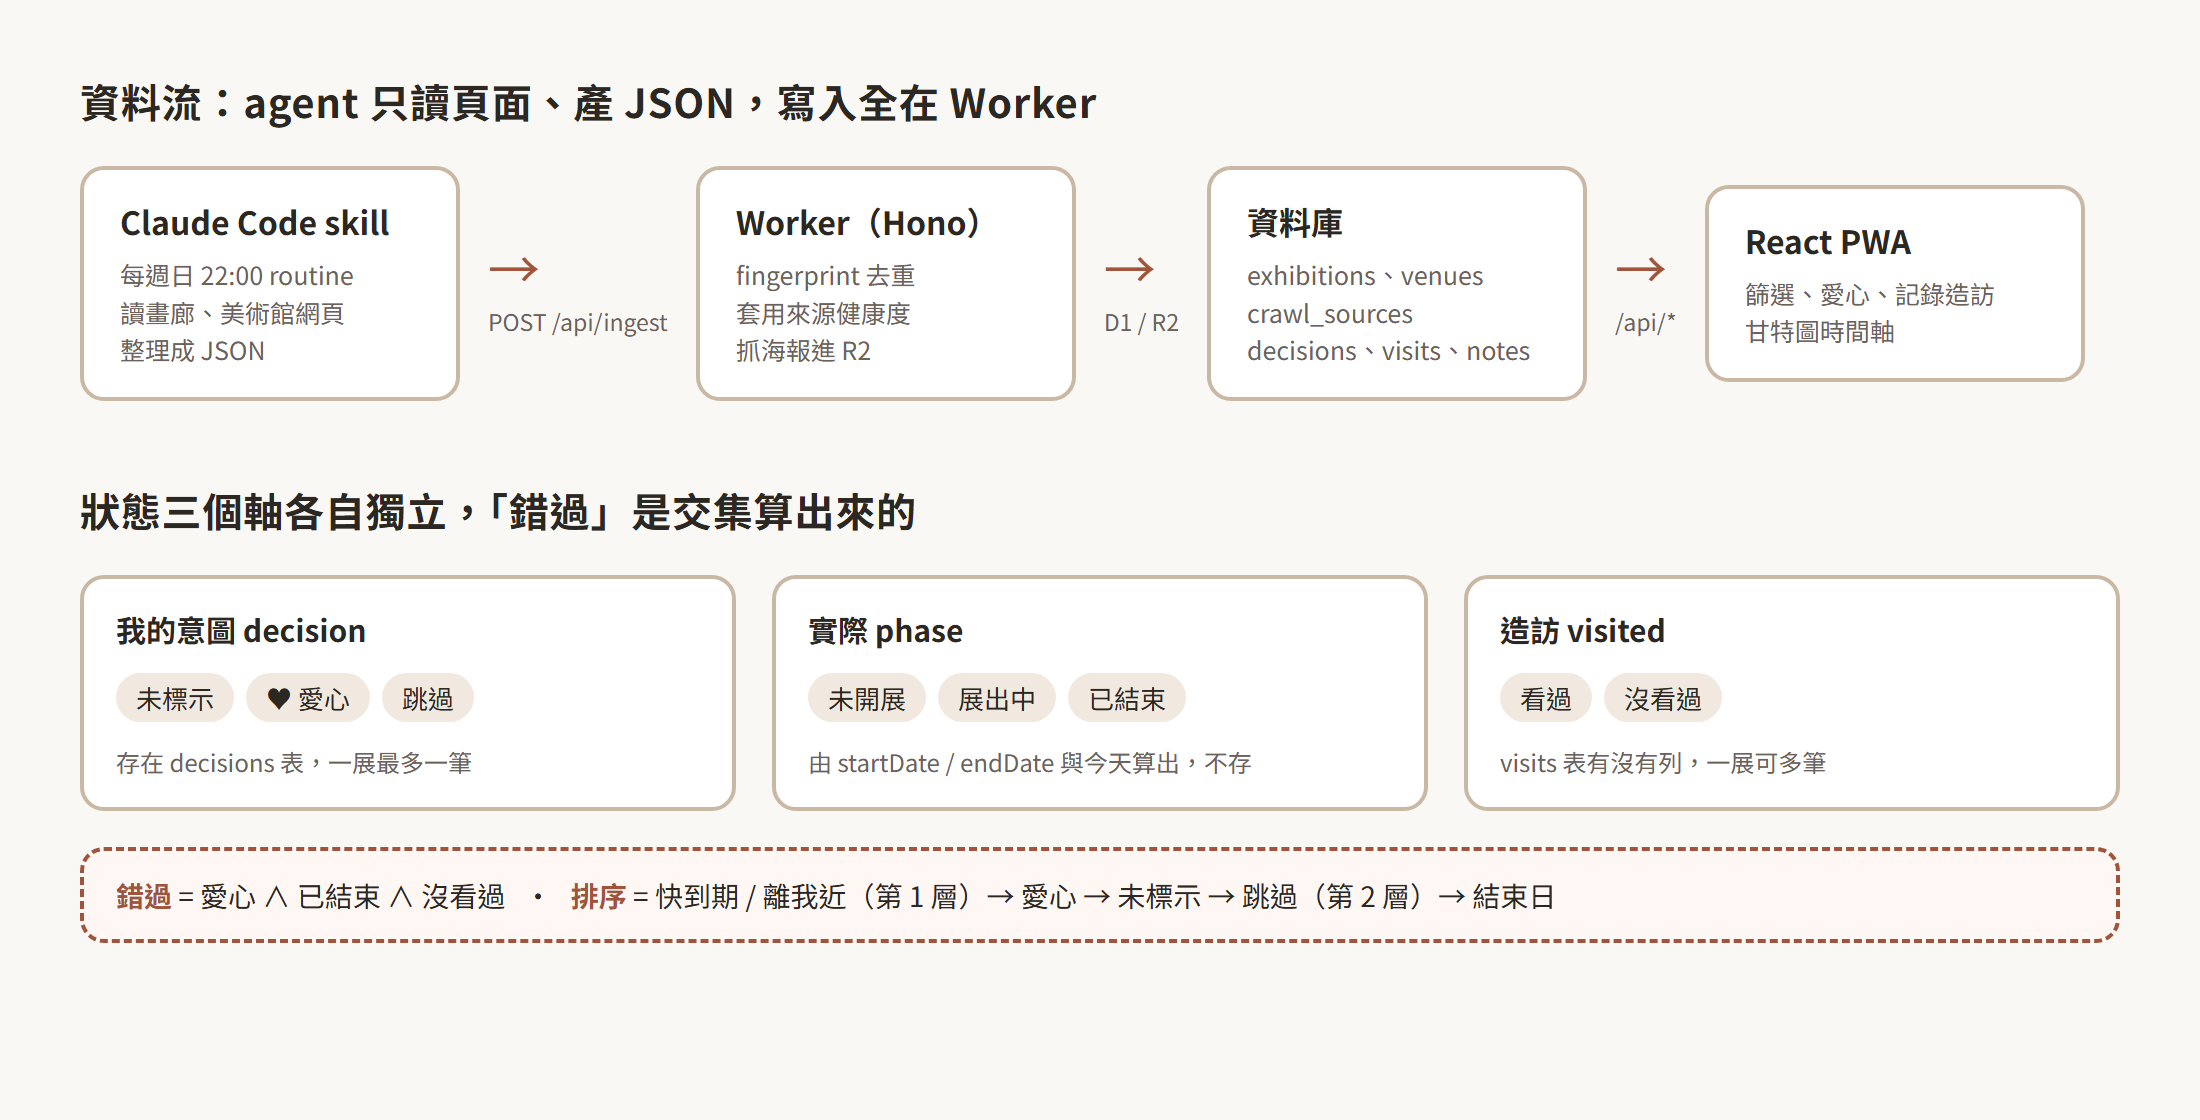
設計重點在於agent 的權限只會到產出 JSON。去重、寫入、抓海報、歸檔,全部是 Worker 端的確定性程式碼。理由是 agent 的輸出會飄,同一個網頁兩次抓可能標題差一個標點;如果讓它直接寫資料庫,每次都會多出重複的展。所以才選擇將探索交給 agent,確定的部分透過重複且可驗證的程式碼來捕抓,避免將不確定的內容塞入到資料庫內。
而要抓哪些網站也不寫死在 skill 裡,會是存在資料庫的 crawl_sources 表,每一列帶著給 agent 看的自然語言指示。以 Bluerider 為例,seed 裡是這樣寫的:
{
  id: "bluerider",
  name: "Bluerider ART",
  kind: "website",
  url: "https://blueriderart.com/tw/exhibitions/",
  instructions:
    "靜態 HTML,分「現正展出 / 即將展出 / 過去展覽」。只取台北·敦南、台北·微風、台北·仁愛三個空間,排除上海、倫敦、洛杉磯。場館依標題前綴【台北·敦化】→ bluerider-dunnan、【台北·微風】或「微風廣場」→ bluerider-breeze、【台北·仁愛】→ bluerider-renai。展期格式如 2026.9.11–12.31(跨年時第二段可能省略年份)。",
}
這段話以前是寫在爬蟲程式碼裡的 if/else,現在變成一段中文,改起來不用重新部署,網頁上就能編輯。agent 開跑時先 GET /api/crawl-sources 拿清單,照著 instructions 做。
二、只做台北,但畫廊要收
美術館資訊本來就好找,會需要抓取的是畫廊和替代空間的小型個展,Bluerider ART 則是我自己一定要有的那家。資訊上,文化部的展覽 API 全國 346 筆裡台北只有 33 筆,而且居然沒有北美館,所以畫廊與美術館主要還是靠 agent 巡官網,API 只是補充。
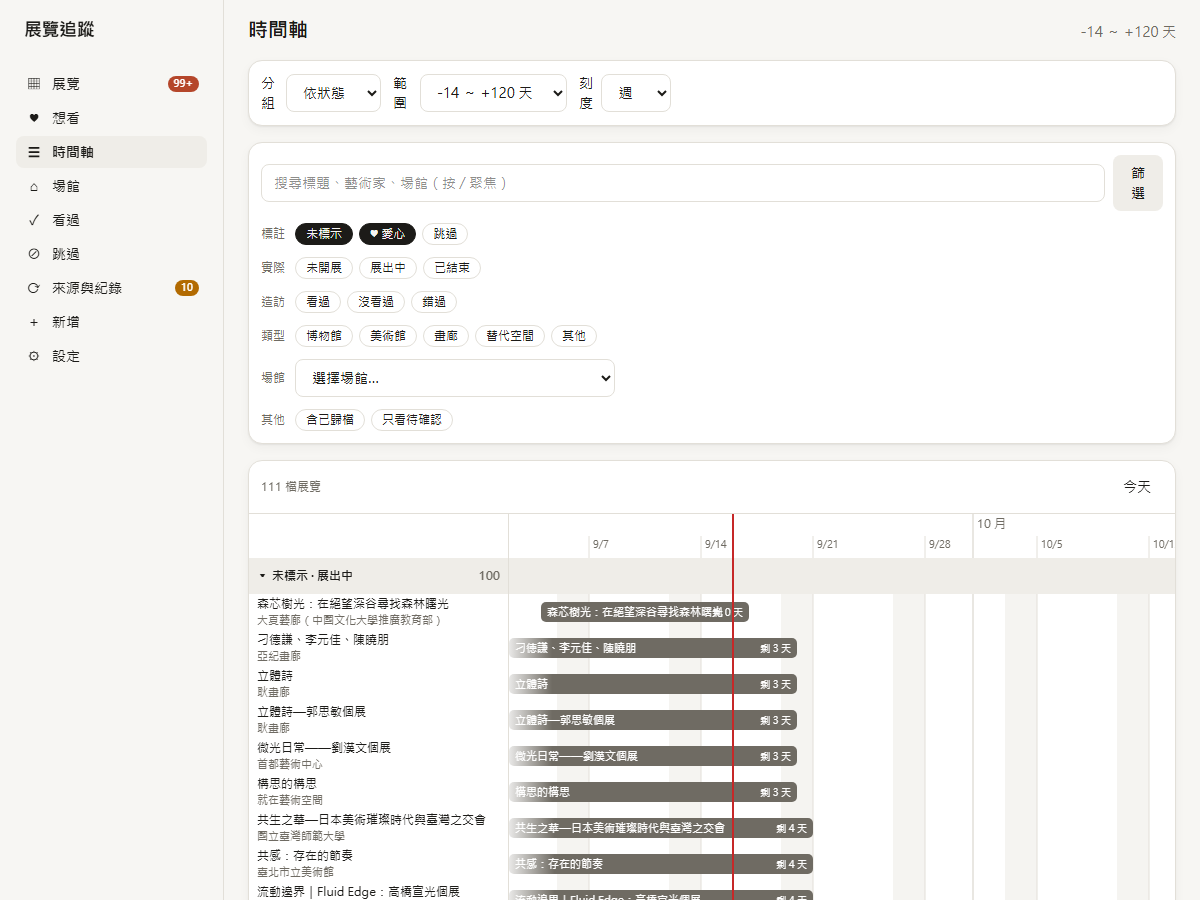
展覽地圖第一版先拿掉,因為有點複雜;先用甘特圖時間軸,讓我可以知道哪個展覽即將結束。第一版還有推薦系統,但這次就先砍掉。第一版舊資料全部砍掉重來。
時間軸可以依狀態或場館分組,依場館分組時追蹤的場館排前面:
export function groupExhibitions(items: ExhibitionDto[], by: GroupBy): GanttGroup[] {
  const byEnd = (a, b) => (a.endDate ?? "9999").localeCompare(b.endDate ?? "9999") || a.title.localeCompare(b.title);
  if (by === "none") return [{ key: "all", title: "全部", items: [...items].sort(byEnd) }];
  if (by === "venue") {
    const map = new Map<string, GanttGroup>();
    for (const e of items) {
      const g = map.get(e.venue.id) ?? { key: e.venue.id, title: e.venue.name, items: [] };
      g.items.push(e);
      map.set(e.venue.id, g);
    }
    return [...map.values()]
      .sort((a, b) => Number(b.items[0]!.venue.followed) - Number(a.items[0]!.venue.followed) || a.title.localeCompare(b.title, "zh-Hant"))
      .map((g) => ({ ...g, items: g.items.sort(byEnd) }));
  }
  // ...
}
三、「我想不想去」和「我去過了沒」分開記
將我對於展覽的狀態分成三種:展覽存亡、我的興趣與我的造訪
- 未開展、展出中、已結束是日期算出來的,每天都會變,存起來反而會過期。
- 愛心和跳過是我的意圖,會改變主意。
- 去過是事實,而且同一檔展可能去兩次。
三個軸各自獨立,「痛苦錯過」就是「有愛心、已結束、沒去過」的交集,不需要另外標。筆記掛在展覽或場館上,之後或許可以跟我的 IG @kiwiartwalk 連結在一起。
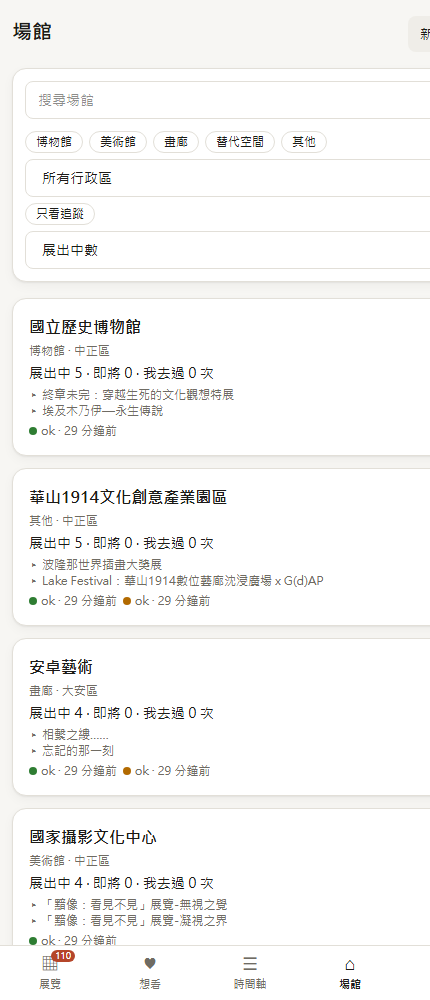
場館因此也是一個獨立的頁面,不只是展覽的一個欄位:每個場館列出展出中和即將的檔數、我去過幾次、來源狀態燈,可以勾「追蹤」。追蹤的場館會出現在首頁的「追蹤場館」chip 和時間軸分組的最前面。
四、首頁則像是 Inbox
原本第一版規劃的是要求一定要左滑右滑:每檔新展都要按愛心或跳過才會離開列表。我這次覺得太死,看展是興趣不是待辦,很多展我就是「看到了、還沒想好」,更多會是剛好有人推播給我,我反而有興趣了。最後是依「愛心 / 未標示 / 跳過」分成三段,只用一個「新」標記提示,想標再標。
五、排序聽誰的
我想要愛心優先、再來未標示、最後跳過。但快結束的展和離我最近的展,不管有沒有愛心都應該先看到,不然愛心一多,剩三天的展會被壓在下面。所以排序是多層的:「快到期」和「離我近」在第一層,愛心在第二層,最後才是結束日。快捷 chip 有「7 天內結束」「離我 2 km」「追蹤場館」「新」「免費」,可以疊加。
這個排序可能是我之後還會調整的細節。
六、來源壞了要看得到
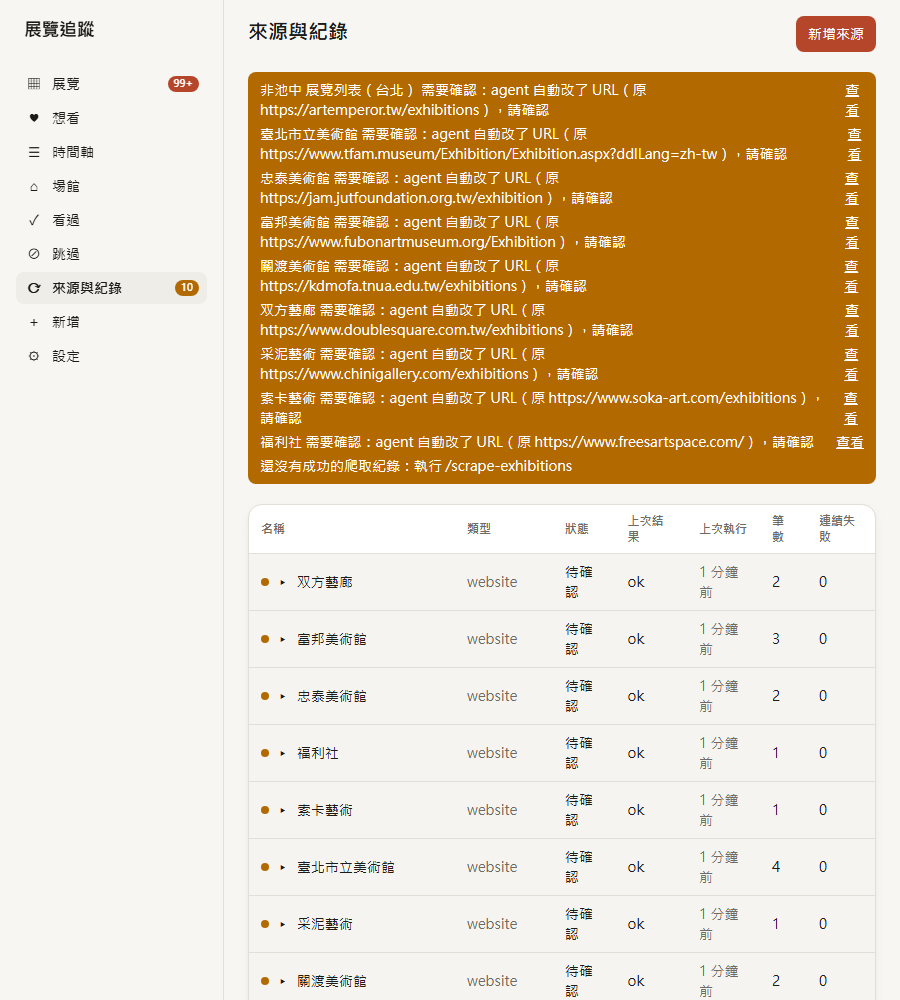
我問的問題是「哪個網站一直抓失敗,我會知道嗎,或是你能自己恢復嗎」。答案是兩個都要:連續失敗兩次首頁亮警示,四次自動暫停;agent 自己找到新網址時不直接改,標成待確認讓我按一下。第一次正式抓取就用上了:27 個來源裡有 9 個的網址被 agent 換掉,來源頁一排黃色提示等我確認。
實作
六個取捨落到程式上,就是下面這張圖:agent 只讀頁面、產 JSON,去重、寫入、抓圖全在 Worker;狀態三個軸各自一張表或一個算式。
ingest 合約:agent 與 Worker 之間唯一的介面
agent 送進來的 payload 用 zod 定義,前後端共用同一份。重點是 sourceReports 和 partial 這兩個欄位,它們是「來源健康度」和「歸檔」兩個功能的資料來源:
export const sourceReport = z.object({
  crawlSourceId: z.string().min(1).max(64),
  status: sourceReportStatus, // ok | empty | error
  message: z.string().max(2000).optional(),
  itemCount: z.number().int().min(0),
  // Set when the agent found a replacement URL (see plan §6.5 step 2).
  discoveredUrl: httpUrl.optional(),
});

export const ingestPayload = z.object({
  trigger: z.enum(["routine", "manual"]),
  // true when only some sources were crawled (e.g. --source <id>); partial
  // runs never count toward archiving unseen exhibitions.
  partial: z.boolean().default(false),
  notes: z.string().max(5000).optional(),
  sourceReports: z.array(sourceReport).max(200).default([]),
  items: z.array(ingestItem).max(1000),
});
每個 item 的 venue 是完整的場館物件(id、name、kind),不是只有 id。這樣 agent 在聚合站遇到沒見過的畫廊可以直接建新場館,Worker 端 upsert;第一次抓取非池中就這樣長出 31 個新場館。
意圖與事實是兩張表
decisions 以展覽 id 當主鍵,一展最多一筆,改主意就是 update;visits 一展可多筆,帶日期和評分:
export const decisions = sqliteTable("decisions", {
  exhibitionId: text("exhibition_id").primaryKey().references(() => exhibitions.id, { onDelete: "cascade" }),
  kind: text("kind").notNull(), // interested | skip
  // ...
});

export const visits = sqliteTable("visits", {
  id: text("id").primaryKey(),
  exhibitionId: text("exhibition_id").notNull().references(() => exhibitions.id, { onDelete: "cascade" }),
  visitedAt: text("visited_at").notNull(),
  rating: integer("rating"),
  // ...
});

// Attached to an exhibition or a venue (exactly one).
export const notes = sqliteTable("notes", {
  id: text("id").primaryKey(),
  exhibitionId: text("exhibition_id").references(() => exhibitions.id, { onDelete: "cascade" }),
  venueId: text("venue_id").references(() => venues.id, { onDelete: "cascade" }),
  body: text("body").notNull(),
  // ...
});
狀態不存,前後端共用同一個函式算
export function phaseOf(today: string, startDate, endDate): Phase {
  if (startDate && today < startDate) return "upcoming";
  if (endDate && today > endDate) return "ended";
  if (startDate || endDate) return "ongoing";
  return "unknown";
}

export function statusOf(today: string, input: StatusInput): Status {
  const phase = phaseOf(today, input.startDate, input.endDate);
  const visited = input.visitCount > 0;
  const missed = input.decision === "interested" && phase === "ended" && !visited;
  return {
    phase,
    decision: input.decision,
    visited,
    missed,
    daysLeft: input.endDate ? daysBetween(today, input.endDate) : null,
    daysUntilStart: phase === "upcoming" && input.startDate ? daysBetween(today, input.startDate) : null,
  };
}
日期都是 YYYY-MM-DD 字串,直接用字串比大小就對,不用轉 Date。missed 是三個軸的交集,改任何一軸它就自動跟著變;卡片上的「剩 0 天」就是 daysLeft。
排序:快到期壓過愛心
排序在前端跑,因為距離要用當下的定位算,伺服器算不了。comparator 用 chain 串起來,順序就是層級:
const byDecision = (a, b) => decisionRank(a.decision) - decisionRank(b.decision); // interested 0, none 1, skip 2

export const COMPARATORS: Record<SortKey, Cmp<Sortable>> = {
  composite: chain(byDecision, byEnd, byStart, byTitle),
  closing: chain(upcomingLast, byEnd, byDecision, byStart, byTitle),
  distance: chain(byDistance, byDecision, byEnd, byTitle),
  // ...
};

export function comparatorFor(sort: SortKey, opts: { closing?: boolean; distance?: boolean } = {}): Cmp<Sortable> {
  if (opts.closing && opts.distance) return chain(upcomingLast, byEnd, byDistance, byDecision, byTitle);
  if (opts.closing) return COMPARATORS.closing;
  if (opts.distance) return COMPARATORS.distance;
  return COMPARATORS[sort];
}
預設的 composite 是愛心優先;一開「7 天內結束」chip,byEnd 就跑到 byDecision 前面。兩個 chip 都開時,快到期第一層、距離第二層、愛心第三層。
去重靠 fingerprint,不靠 agent 記得上次抓過什麼
同一檔展在官網和聚合站的標題常差一個書名號或全形空格,所以先正規化再組 key:
/**
 * Lowercase, half-width, no punctuation/brackets/whitespace, NFKC-folded.
 * "《少年行》— 台灣青年藝術家聯展 (2026)" and "少年行 台灣青年藝術家聯展 2026"
 * normalize to the same string.
 */
export function normalizeTitle(title: string): string {
  return toHalfWidth(title.normalize("NFKC"))
    .toLowerCase()
    .replace(/[\p{P}\p{S}\s]+/gu, "");
}

export function fingerprintOf(venueId: string, title: string, startDate: string | null | undefined): string {
  return `${venueId}|${normalizeTitle(title)}|${startDate ?? ""}`;
}
exhibitions.fingerprint 是 UNIQUE,寫入用 ON CONFLICT DO UPDATE。更新時每個欄位都是 coalesce(新值, 舊值),agent 這次沒抓到的欄位不會把上次的洗掉;而且有一條 setWhere 保護手動修過的資料:
.onConflictDoUpdate({
  target: exhibitions.fingerprint,
  set: {
    title: item.title,
    sourceUrl: item.sourceUrl,
    endDate: sql`coalesce(${common.endDate}, ${exhibitions.endDate})`,
    imageSrcUrl: sql`coalesce(${item.imageUrl ?? null}, ${exhibitions.imageSrcUrl})`,
    lastSeenAt: startedAt,
    lastSeenRunId: partial ? sql`${exhibitions.lastSeenRunId}` : runId,
    archivedAt: null,
    // ...
  },
  // never overwrite a hand-entered row that won the race
  setWhere: sql`${exhibitions.manual} = 0 and ${exhibitions.lastSeenAt} < ${startedAt}`,
})
第一次抓取 115 筆裡就有 4 筆這樣被合併掉,都是官網和非池中抓到同一檔展。
來源健康度在 SQL 裡算,agent 只回報成功或失敗
const failuresExpr = ok ? sql`0` : sql`${crawlSources.consecutiveFailures} + 1`;
const pausedExpr = ok
  ? crawlSources.status
  : sql`case when ${crawlSources.status} = 'active' and ${crawlSources.consecutiveFailures} + 1 >= ${PAUSE_AFTER_FAILURES} then 'paused' else ${crawlSources.status} end`;
// ...
consecutiveFailures: failuresExpr,
status: discovered ? "needs_review" : pausedExpr,
reviewReason: discovered ? `agent 自動改了 URL(原 ${cur.url}),請確認` : pausedReasonExpr,
discovered 是 agent 回報「我找到新網址了」,這時不改 URL,只把狀態設成 needs_review,來源頁就會出現上面截圖那排黃色提示,按「採用」才真的換。
歸檔也是同一個思路,不信任單次結果:一檔展要「已結束、而且最近三次完整且沒有錯誤的抓取都沒看到它」才會被歸檔。部分抓取(--source <id>)和有錯誤的那次都不算,因為那些 run 根本沒看到它不代表它消失了:
export const ARCHIVE_AFTER_MISSED_RUNS = 3;

const recent = await db
  .select({ id: ingestRuns.id })
  .from(ingestRuns)
  // complete runs that finished without item/source errors
  .where(and(isNotNull(ingestRuns.finishedAt), isNull(ingestRuns.errors), eq(ingestRuns.partial, false)))
  .orderBy(desc(ingestRuns.startedAt), sql`rowid desc`)
  .limit(ARCHIVE_AFTER_MISSED_RUNS);
if (recent.length < ARCHIVE_AFTER_MISSED_RUNS) return 0;
小結
六個取捨定下來後,下一個問題是用什麼做、放在哪裡。第一版跑在 Vercel + Supabase 上,我的其他 side project 則是 GitHub Pages 放前端、Supabase 放資料,這次兩條路都沒走,整個搬到 Cloudflare。明天講為什麼:GitHub Pages + Supabase 少了什麼、Vercel 那套哪裡不順,以及 Hono、D1、R2 這幾個選擇各自的理由。