我之前在筆記裡記了一句:「當你有很多想法時,又知道這些 AI 都做得到時,才發現你才是那個卡住 pipeline 的瓶頸,你是小丑。」
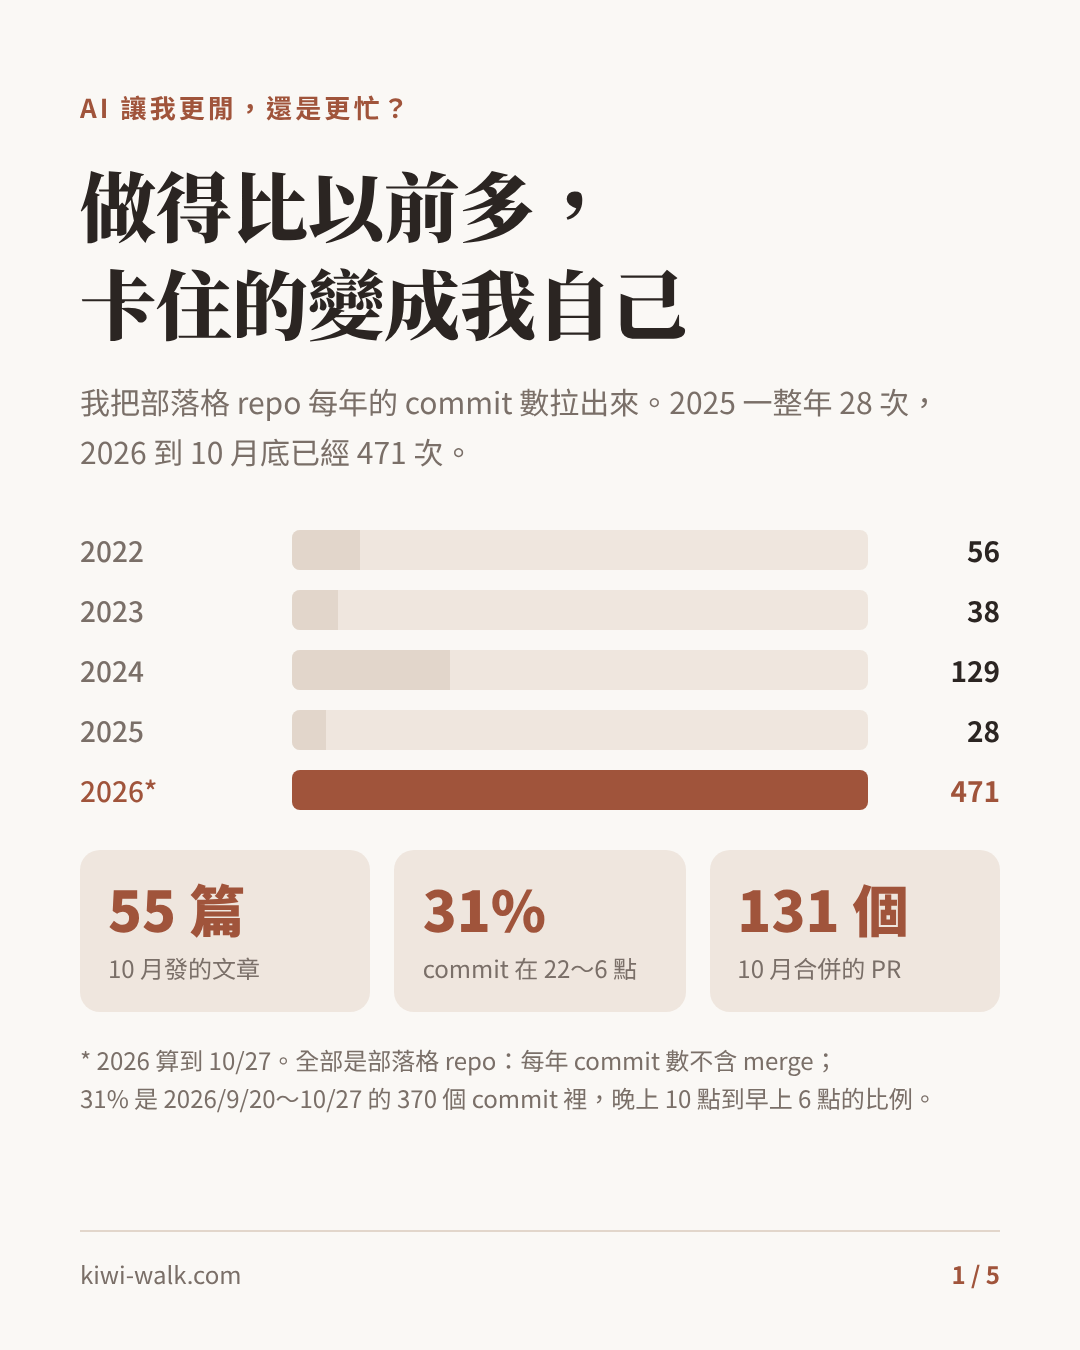
最近讀到〈AI promised less work. I’ve never worked more〉,作者用自己的 GitHub 貢獻數說明,AI 讓他做得更多、更累。引發我的好奇,所以我也把部落格 repo 的動態算出來看:2025 一整年 28 個 commit,2026 到 10 月底已經 471 個。(想到今天看到 github commit 次數的暴增,導致他們的服務不穩定,要加更多的機器支援)
因為 AI 執行的快速便宜,影響實作的沒有消失,仍舊在人的身上。
瓶頸移到哪裡
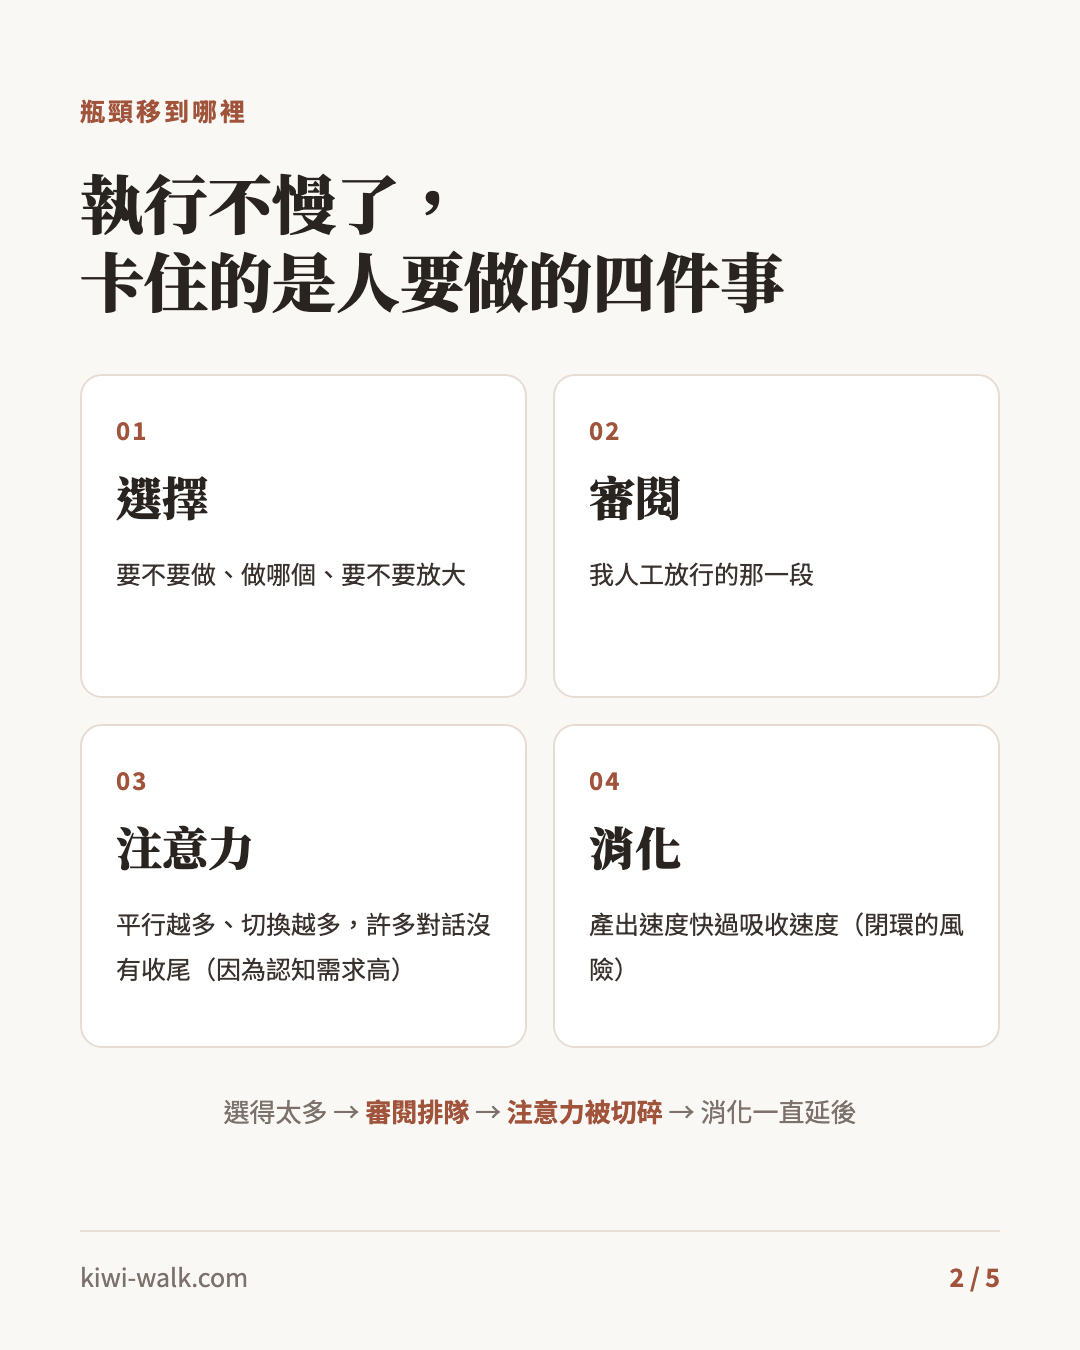
執行不慢了,卡住的是人要做的四件事
| 段落 | 卡在什麼 |
|---|---|
| 選擇 | 要不要做、做哪個、要不要放大 |
| 審閱 | 我人工放行的那一段 |
| 注意力 | 平行越多、切換越多,許多對話沒有收尾(因為認知需求高) |
| 消化 | 產出速度快過吸收速度(閉環的風險) |
四段不是互斥的。選得太多會讓審閱排隊,審閱排隊會把注意力切碎,切碎的注意力又讓消化一直被延後。
A. 選擇
AI 把「做」變便宜,問題從「怎麼做」變成「要不要做」
從執行者到選擇者
過去十年我是執行者,拿到需求想的是如何實作,這個 function 打完,我要接上哪個,來完成功能。只是在 AI 把「做」變得通俗後,「HOW」漸漸退場,而「要不要做」「做哪個」「要不要放大」變成新的瓶頸。
從執行者到選擇者 把選擇者拆成三個動作:
- 問對問題:知道背景與脈絡,才能找到對症下藥的問題句子
- 讓 AI 先說出它的假設:人不知自己不知的,給予點模糊讓 AI 協助我們擴展,避免我們狹隘
- 用辨識力取代製作力:真正製造出差異的地方,細節是當前重要,辨識哪裡是功能關鍵點,去改他。AI 不會理解人類的痛點
工具清單再熟,如果這三個動作沒到位,產出只是更精緻地走錯方向。
摩擦力是過濾器
Vibe-coding 應從自用工具開始 聯想到過去「因做起來很花時間」的摩擦力,其實是殘缺的需求過濾器,很多好點子死在「無法花長時間研究製作」這關。
摩擦力歸零後,瓶頸前移到「你能否真的知道自己要什麼」,AI 反而可能成為需求模糊的加速器。反過來說,加速器擴充更多迷霧,一堆不需要的功能,全然只是堆積垃圾,而沒人會想用的工具。
BFS 體質
我之前只寫了兩行:「可能是我常探索,而非執行,因此我的知識可能相較起來比別人扎實,但開發可能都偏慢」。(也或許是我很自由矛盾)
在選擇者的世界,看廣再決定深是優點。但風險有兩個: 探索到一個程度卻沒切到深做,以及把「看了五個方案」誤當成「選了一個」。
隔靴搔癢
從手刻到 AI 的手感是這樣的:「就像一直指示員工做事,但每次都要等他回來,我才能知道」。另一個痛點會是無法權衡 plan 與直接寫的時間,花一兩個小時 plan,是不是不如自己跳下去。不過後面這個隨著 ai 進步,時間也越來越快。
B. 審閱
不是慢,是卡在需要我放行的那一段
兩種審閱
如同我在〈從來來回回到共同語言,減少 AI 協作瓶頸〉寫的,產出不慢,卡住的是需要我放行的那段。
審閱有兩種:「對不對」可以交給證據,「是不是我要的」只能我判斷。大部分我遇到的是後者,UI 和功能的實際測試,這兩者我都需要看到實體才判斷得出來。至於前者我目前主要的就是完整的 plan,寫好 AC,確保 session 執行完成的 AC 是成功的。
看到才說得出來
第一時間描述需求時超模糊,唯有看到 mock 後才知道哪裡怪、可以改什麼。所以 mock 不只是被審閱的東西,也是將意圖翻成語言的中介,細節在 意圖經過實體才變成語言。同時間,想到大家推薦讓 AI 回饋的資訊,從文字、HTML 到影片,讓我們加速判斷。
而每一次「再改一下」,可以分成兩種:補條件輪是第一個描述漏講了條件,可以事先省;說服輪是還沒親眼看到不妥協的代價,省不掉,只能搬到實作之前。兩種的對照在 補條件輪與說服輪。
plan 的來回
plan 審查來回很多輪時,輪數本身雖不代表原因(plan 來回診斷)。問題會是落在新加的段落、類別一直換,範圍不斷擴充;但同一類問題反覆出現,是做法或背景知識有問題,有時要你自己發現出來,不然就只是在跟 ai 跳恰恰。
事前對齊只省得掉補條件輪,session 中途長出來的範圍,要靠停損與只查新增的部分。
別人也卡在這裡
我整理 多 session 協調 時看到的外部做法,結論一樣:瓶頸在人和主控 session 的 context,不在 agent 數。
- Simon Willison 一次只能好好審一個重大改動(原文)。
- Context Studios 建議看「diff 等多久才被審」決定並行數,等待變長代表加 agent 只是在加排隊(原文)。
- HN 的討論裡,多數人覺得 2~3 個並行最舒服;而我一天 3~7 個 child session,落在區間上緣。但主要也是因為我的 side project 平均負擔沒到高。
Claude Code 團隊的做法,是把「有沒有人讀過」換成「這個變更會怎麼壞、該由哪道檢查抓」(Claude Code 團隊的 code review),也就是把「對不對」交給檢查層。
C. 注意力
平行越多、切換越多,許多對話沒有收尾
延續上面提到的多 session 卡住,這裡就更深入提到破碎的注意力。
能做更多,就做更多
開頭那篇的作者 Orestis Ioannou,agent 讓寫程式變便宜,他就能接下更多事,包括以前會放掉的 bug 和專案。
好幾個 agent 平行跑,等待時就切換,不斷切換脈絡,回應著事情,反而比以前專注在一兩件事更累。安靜的時段也不再真的安靜,因為一直會有 IDLE session 在等著。想到以前學 OS 的時候,提到 context switch 都會跟我們說盡量避免,不然效率會下降,結果現在人類卻同樣陷入這狀況。
而且現在不需要在電腦前面才行修改專案了。
HN 的三種說法
這篇在 HN 上的討論串,提到了三件我覺得很能同理的觀點:
- 腦子裡要記的事變多:englishspot 說「so did the number of things I have to keep track of in my head」;thatguymike 說「the 5-10x increase in context switching, which is itself draining」。
- 手機遙控停不下來:tantaman 說「Now that something can work 24/7, you must be available 24/7 to keep it working.」;carlgreene 後來把主要手機換成只能打電話的折疊機。
- 好處歸雇主:everdrive 說「Once a person can do more, an employer will require more.」
也有人提了解法:juanre 只跟五個左右的協調者講話,所以「I get to think, and pause, and focus again」;arend321 是自己決定下次什麼時候被通知;milesvp 的團隊開始退票、每週少接任務。
沒有天花板的電玩
為什麼 vibe coding 這麼讓人上癮?我覺得它更驗證了「所想即所得」的落地。我們能決定目標,思想一到 agent 就可以建造出隨我們擺弄的玩具,可以完全照自己的直覺去試。
D. 消化
產出速度快過吸收速度
消化債
我在 AI 略過感與消化債 寫過:我無法收納 AI 產出的內容,「消化吸收成自己的」永遠被延後到下一個產出。產出與先前的連結失敗,因為先前的產物只是堆積,經過腦子,不曾在我的知識框架裡面找到位置歸類,忘了是必然的。
延續著,只要我還再一鍵產,這些堆積的必將繼續賒帳。
刻意不知道
注意力是被爭奪的對象,Herbert Simon 說過:資訊的豐盛造成注意力的貧乏。
刻意不知道 的判準可以直接拿來用:你是有能力知道而選擇不知道,還是想知道卻不能?前者是自由,後者是限制。
你要看 agent 執行到哪個程度?是看到 plan?看到 task?還是看到 test?還是到檢查每一行程式碼?在 agent 上,我們是否每一則都要看呢。
刻意選擇資訊的接收,同時也是去阻斷可能的資訊焦慮與爆炸。
與 agent 合作後的數據
以部落格 repo 的 commit 次數當工作量指標
我拿我部落格 repo 的 commit,不含 merge。部落格 repo 從 2022 年就有紀錄,剛好可以當「AI 之前」的基準。
| 年 | commit |
|---|---|
| 2022 | 56 |
| 2023 | 38 |
| 2024 | 129 |
| 2025 | 28 |
| 2026(到 10/27) | 471 |
每月發文:2024~2025 每月 1~5 篇;2026 年 7 月 9 篇、9 月 16 篇、10 月 55 篇。
2026/9/20~10/27 這 38 天:
| 項目 | 數字 |
|---|---|
| commit | 370 |
| 平日 commit 中位數 | 6 |
| 零 commit 的平日 | 27 天裡 4 天 |
| 週末 commit | 96 |
| 晚上 10 點到早上 6 點 | 116(31%) |
我的做法
把要判斷的事固定在少數幾個點,其他則用證據補足
現在的工作流程
我現在的流程寫在〈把 issue 工作流程的底層換成 Matt 的 skill〉:
- triage、spec、tickets、implement 交給 Matt 的 skill
- 我只留下出貨(
issue-ship)、文章(article-request、post-write、writing-voice)和安裝(issue-workflow-setup)
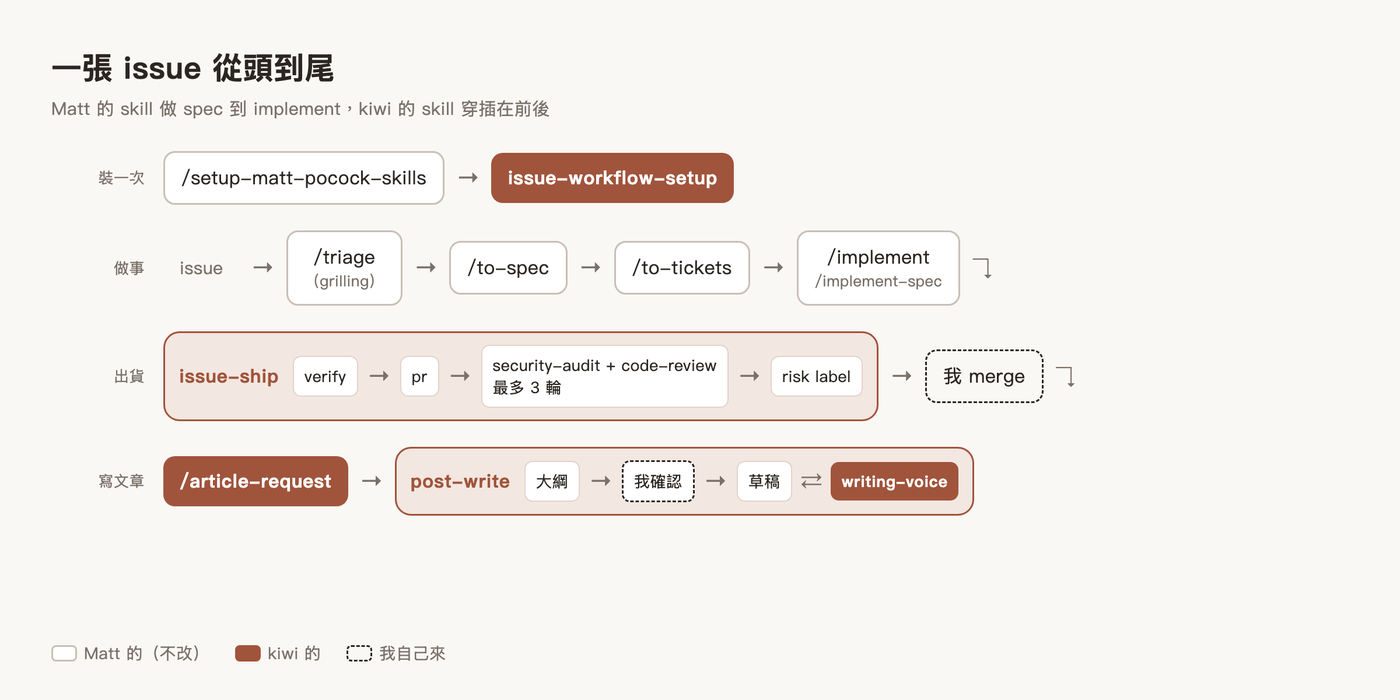
在這之中我基本上都是在 session 互動,避免跨 session 可能的 context 缺漏,特別是文章區塊,以下顯示:
- 文章大綱在對話裡確認。
- 每輪審查的結果在 session 裡決策,PR 只留紀錄。
- 文章素材直接從開發的對話寫。
放行點只留兩個
想法先記成一句話的 issue,AI 讀過 codebase 再補完。我只在兩個地方出現(我發想、AI 完善 issue,平行處理,生產力暴增):
- 完善 issue:讓靈感化作實際計劃,確保這是不是我要且符合實務面的東西,因此會包含 mock。
- 審核 PR:有沒有照 approve 的做、證據在不在。我不逐行讀 code,而是改成讀證據、點 preview 確認。
其中我個人覺得一定要請 agent 列出「沒做到」的區塊,因為那些可能是被自己忽略,或者是在你認知範圍以外卻很重要的項目。
控制批量
跟隨著上面所提到的,每批只會發 3-5 個 agent,過多的 agent session 只會浪費在不斷地切換注意力,注意力如同代幣一天是有上限的。需確保我的審閱是在線,AI 一次產出太多,堆在我前面只會變成無腦的 YES MAN。
協作守則
從開工到上線,我現在怎麼跟 AI 協作
前面幾段講瓶頸在哪,這九條是我現在的做法,讓放行的次數少一點、每次放行更有把握。
動工前
- 計畫嚴謹:確保與 AI 沒有誤會。
- mockup 任何產物:確保出來的畫面與 UI 符合你的需求。就算之後看到串了真的資料,畫面調整,也會大幅的減少調整幅度。
- 不要高估自己對邊界的認知:你負責確保操作脈絡是否涵蓋,功能是否符合自己的想法。餘下的邊界與細節,交給 Agent 完善,但需確保你與 agent 有所共識。
驗收
- 事後驗證:確保 PR 符合當初 ticket 的 acceptance criteria,不能忽略功能上的缺漏。
- web 的 PR 要跑實機測試:要求 AI 截圖畫面給你看是否吻合。
- code review 與 security review 不能少:建議拉開新的 md 檔,與開發的 md 檔分開,避免污染,同時更能針對 review 做特化設置。
- review 多輪不收斂,回頭看做法:若反覆多輪的 review 無法收斂,請回頭檢視做法或是功能上是否缺漏。
合併與上線
- PR 加上風險判斷,你是當責人:PR 生成時,建議加入 AI 判斷此 PR 的風險程度,可依照 Matt 提出的單向門與雙向門概念(可不可以 revert),也可參考 Anthropic 提出的 risk 三層架構。我自己後來把自動合併拿掉,但這個 risk 標籤協助我提高合併的警覺。
- merge 後確認部署:確認部署的 workflow 是否完成。可追加通知或監控,避免開心合併,上線失敗,完全不知道。
結論
- 選擇來自於品味,資訊爆炸下的選擇重要,減少人工審閱,平衡多 agent 與個人注意力切換,最後謹慎注意消化,別讓訊息只經過腦子,你將自身全權交給 AI。
- 我相信需求要看到實體才會明確,第一次描述時沒辦法一步到位;減少來回的關鍵,在第一個描述的轉譯。
- 我在流程裡剩四個動作:勾待決事項、approve、審 medium/high 的 PR、編修文章。這和 Claude Code 團隊「人只保留決定要不要做、高風險程式碼、判讀證據」是同一個方向。
- 選擇者的角色轉換不是直線升級,是局部成熟、局部還沒長出來。
- 放行點變少,不代表放行次數變少。部落格 10 月合併 131 個 PR,說明放行其實很頻繁。