kiwi-walk 架在 Cloudflare 上:網站放 Pages,圖片放 R2 CDN。Cloudflare 後台的 AI Crawl Control 會統計 AI 爬蟲,打開來看,爬蟲比讀者還勤快。以下是 2026-09-12 到 10-12 這 30 天看到的幾件事。
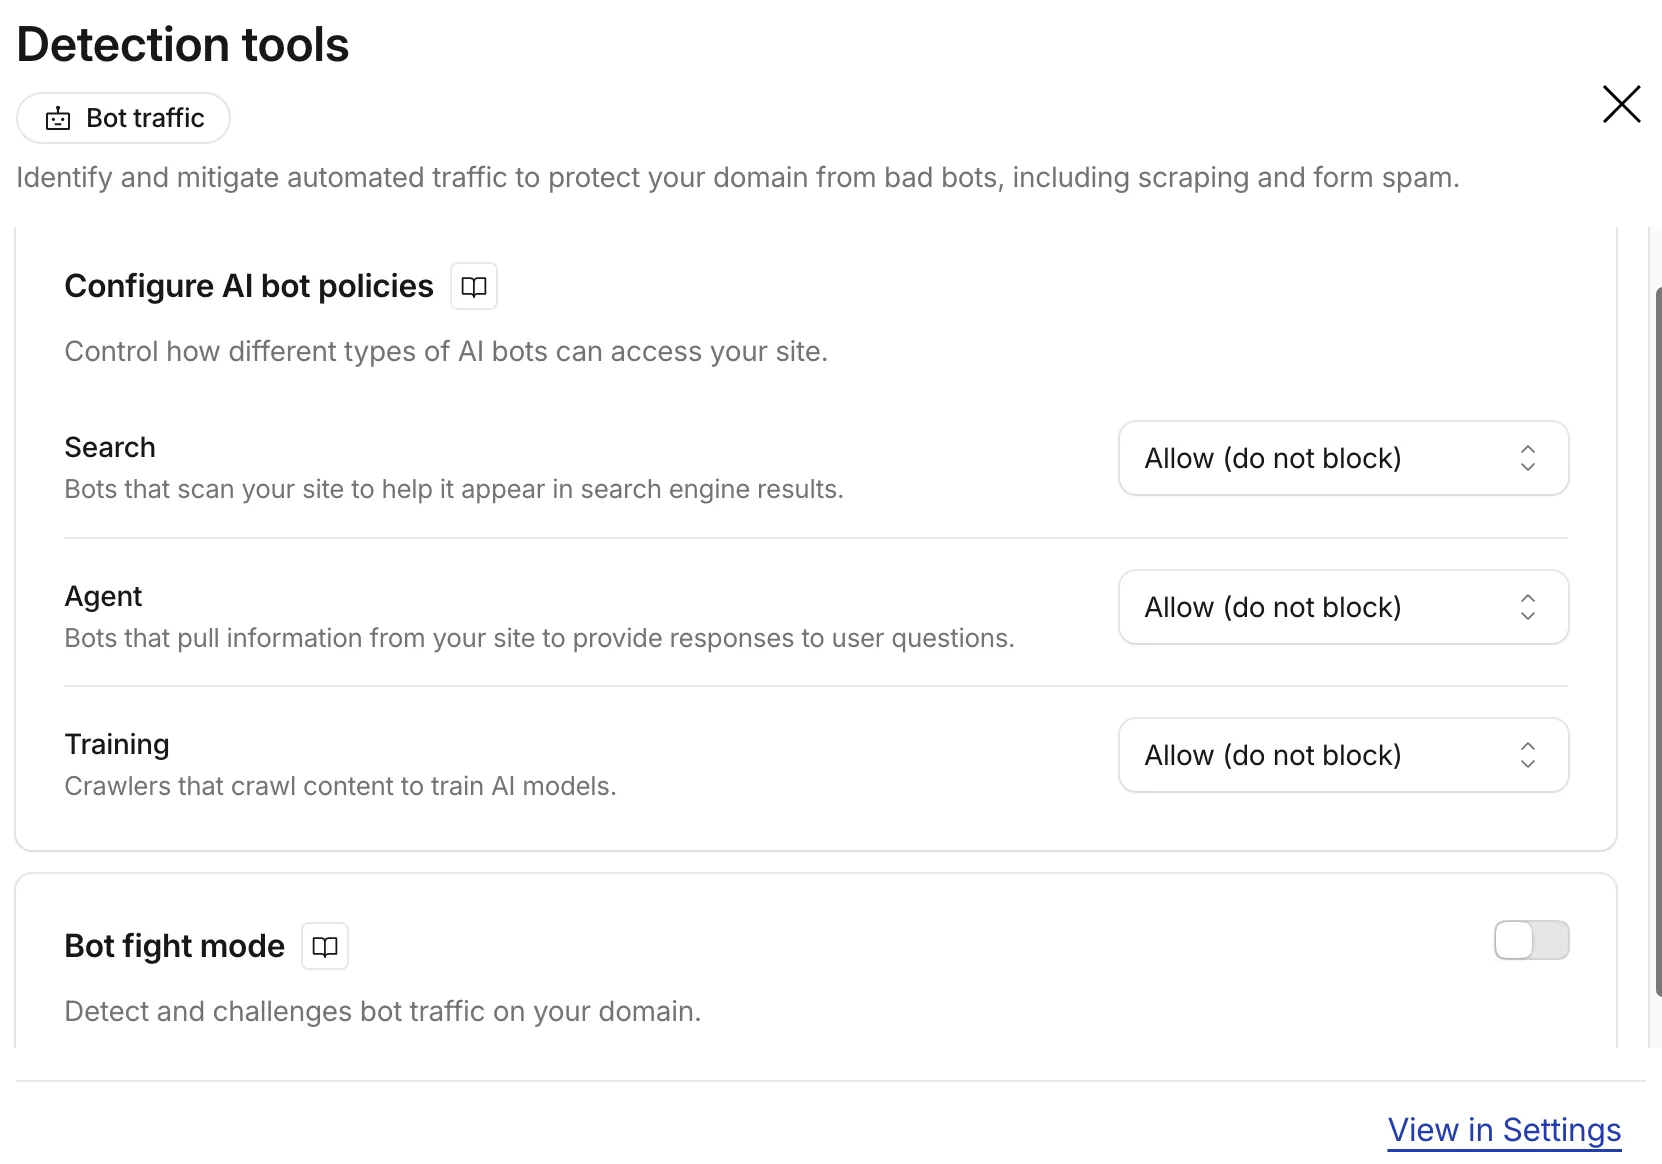
這段期間的設定是全部放行:AI bot policies 的 Search、Agent、Training 三組都是 Allow,Bot fight mode 關,robots.txt 也全部放行,所以這些數字可以當「完全不設防」的基準線。robots.txt 和 OpenAI 兩隻爬蟲的分工(OAI-SearchBot 管 ChatGPT 搜尋,GPTBot 管訓練)在前一篇 SEO 健檢查過,這篇只看實際被誰爬。
訓練爬蟲的比重
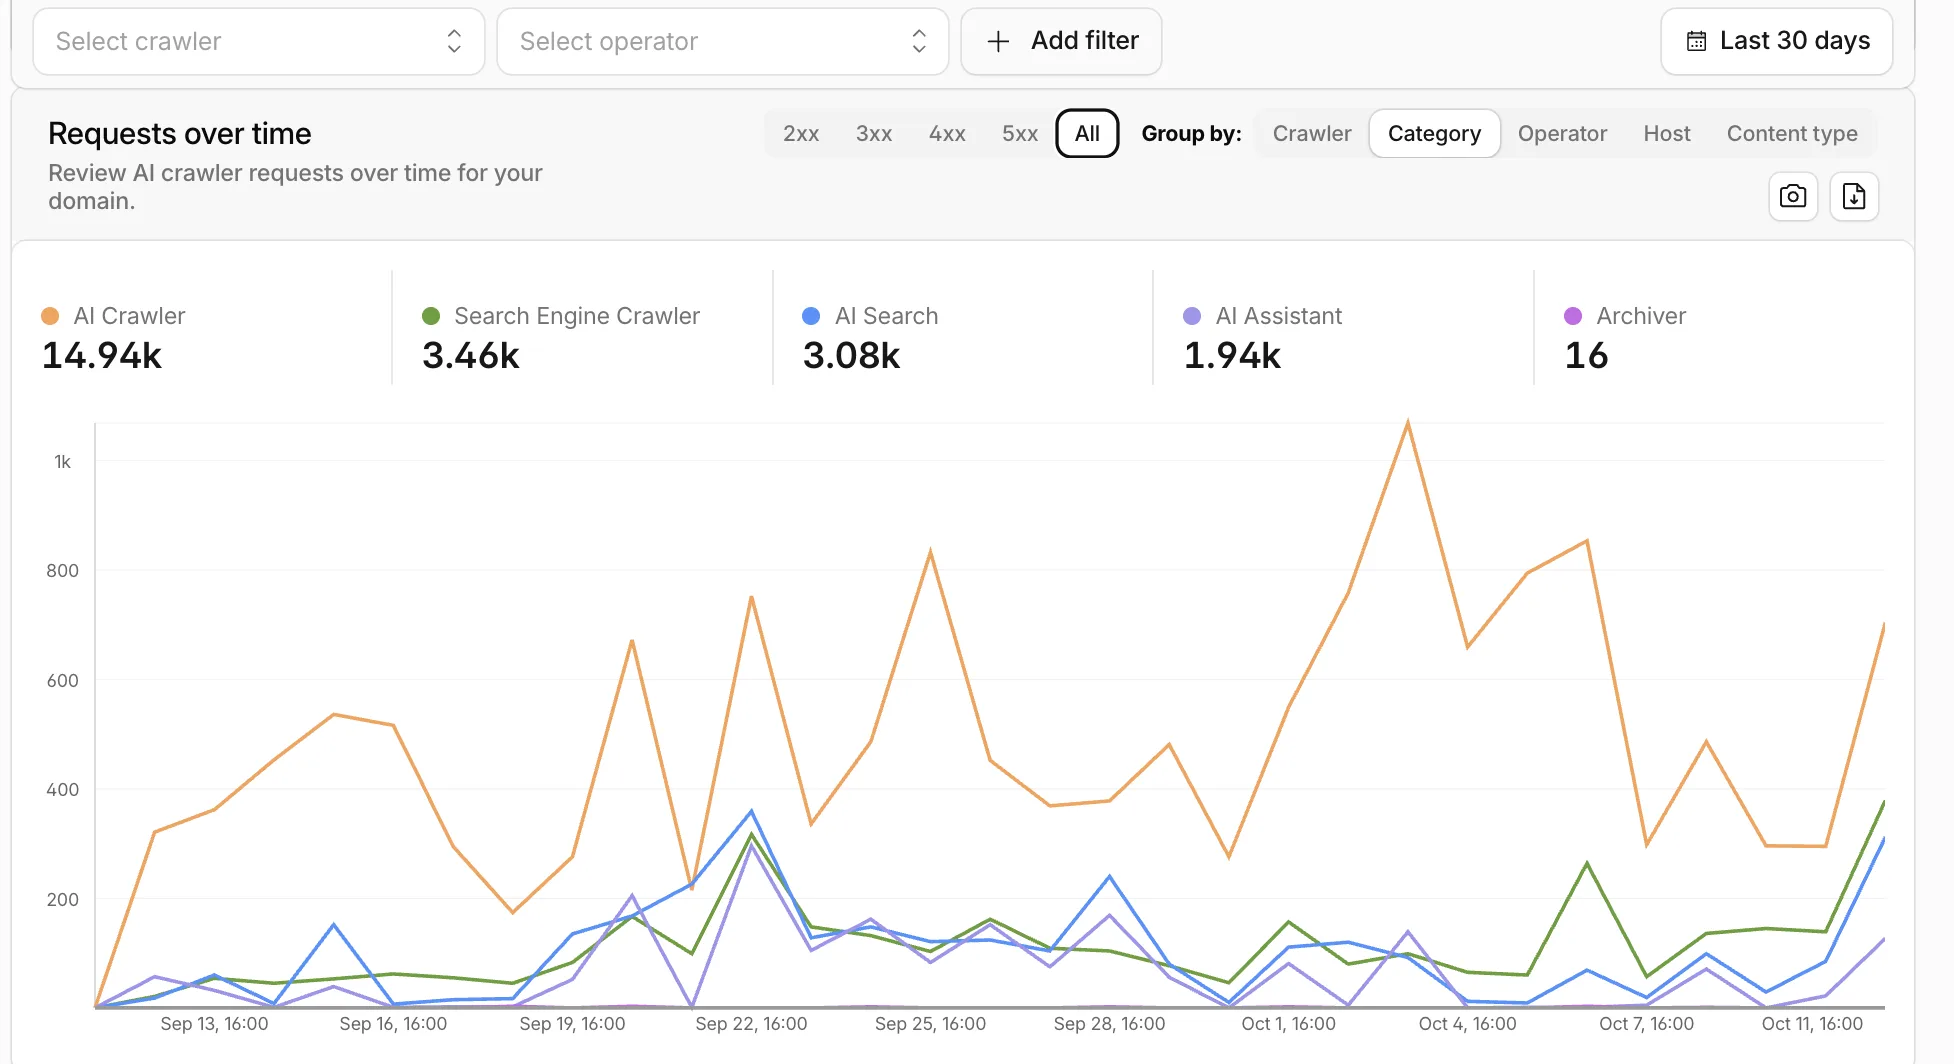
觀察:訓練用的 AI 爬蟲是傳統搜尋爬蟲的 4 倍。
| 類別 | 用途 | 30 天請求 | 成功(2xx) | 4xx 比例 |
|---|---|---|---|---|
| AI Crawler | 抓內容訓練模型 | 14.94k | 8.96k | 31% |
| Search Engine Crawler | 傳統搜尋(Googlebot、Bingbot) | 3.46k | 1.5k | 40% |
| AI Search | AI 搜尋的索引,答案會附連結 | 3.08k | 735 | 71% |
| AI Assistant | 使用者在 ChatGPT、Claude 裡提問時即時抓頁 | 1.94k | 36 | 91% |
| Archiver | 網頁存檔 | 16 | 16 | — |
合計約 2.4 萬次,成功約 1.1 萬次,不到一半;4xx 約 1 萬次。對一個小部落格來說,「被拿去訓練」的量遠大於「被索引給人搜」。
Meta 與其他爬蟲
觀察:Meta 一家就佔成功請求的 44%。
| 爬蟲 | 營運者 | 成功請求 | 佔成功請求 |
|---|---|---|---|
| Meta-ExternalAgent | Meta | 5k | 44% |
| PetalBot | 華為 | 2.13k | 19% |
| ClaudeBot | Anthropic | 790 | 7% |
| Googlebot | 672 | 6% | |
| BingBot | Microsoft | 628 | 6% |
| 其他 11 個 | 2.03k | 18% |
- Meta-ExternalAgent:Meta 官方文件寫它的用途是訓練 AI 模型,或索引內容來改善產品。它和產生 Facebook、Instagram 連結預覽的
facebookexternalhit是不同的爬蟲,擋它不影響分享預覽。30 天抓走了 549.75 MB 圖片。 - PetalBot:華為 Petal Search 的爬蟲,資料也供給華為的助理和 AI 搜尋。台灣讀者幾乎沒人用,卻是第二勤快的訪客。它算不算 AI 爬蟲,各家資料說法不一。
- ClaudeBot:這個部落格的文章多半是和 Claude 一起寫的,寫完又被 ClaudeBot 爬回去 790 次。
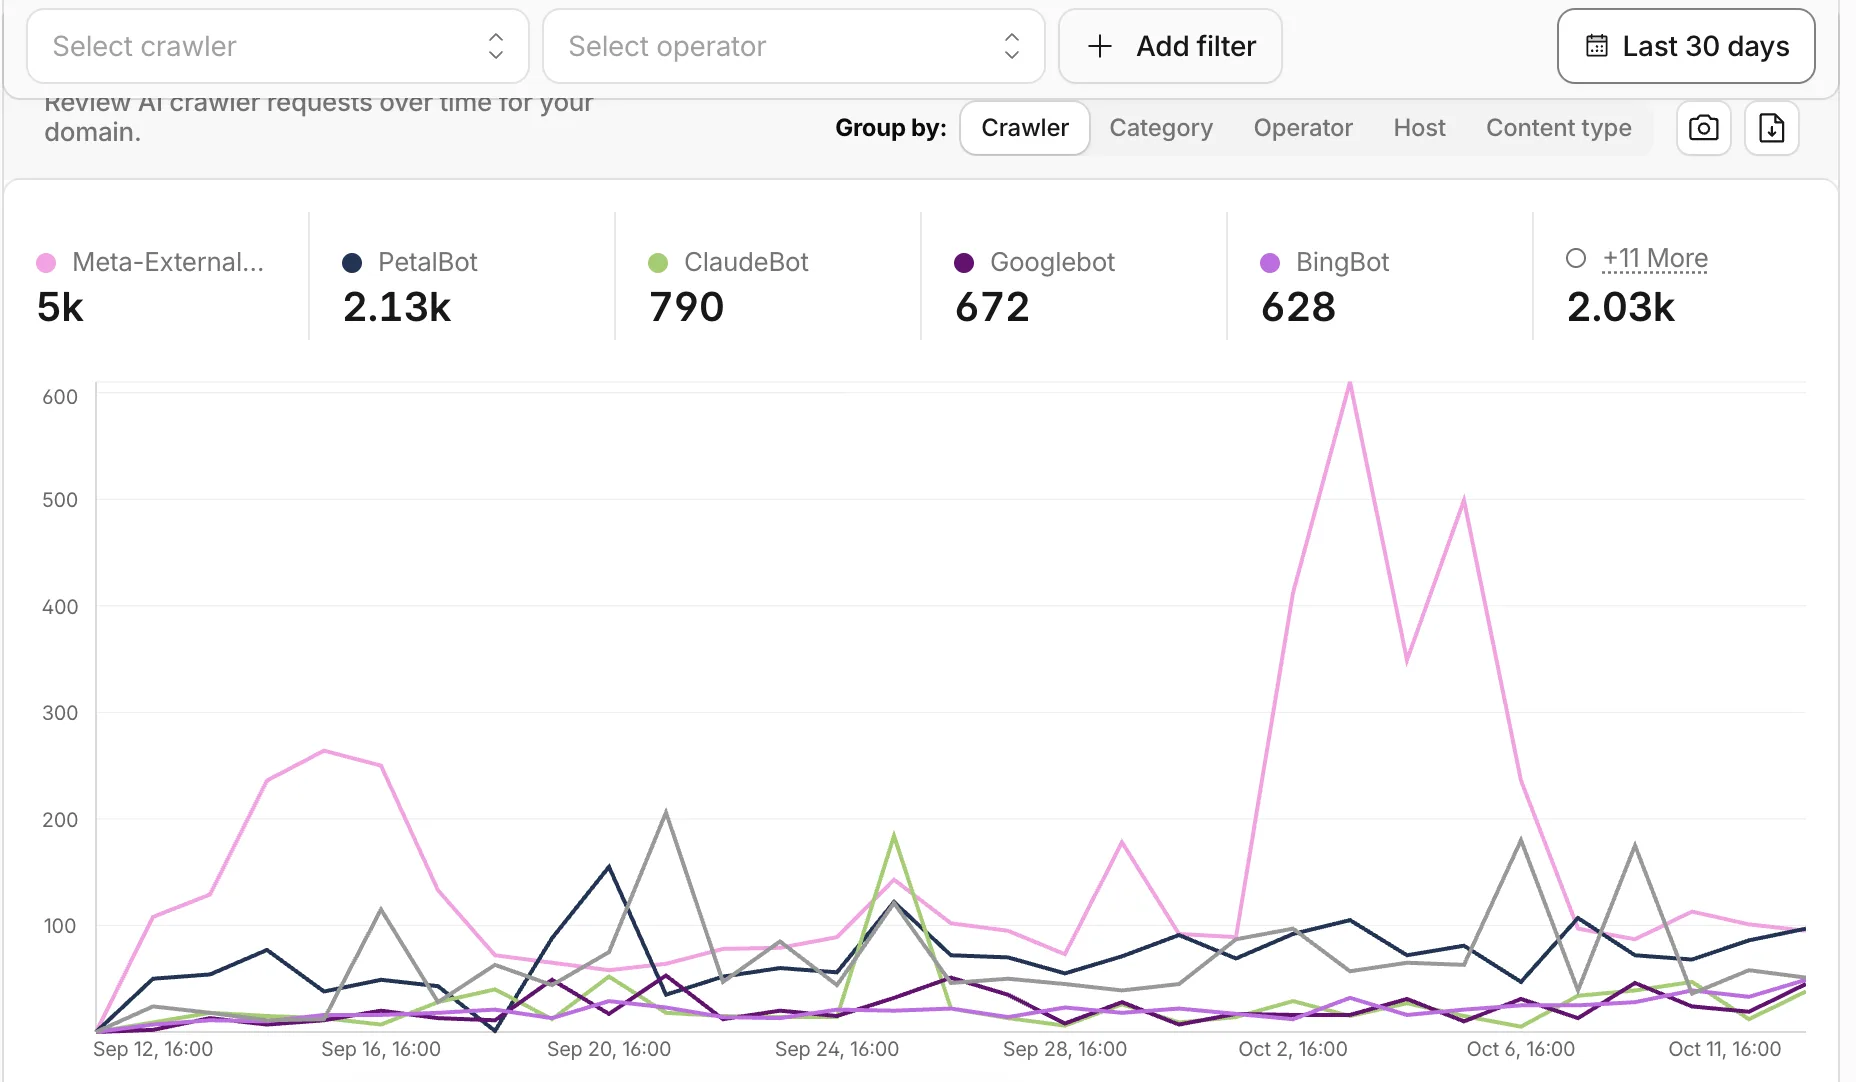
Meta 在 10/2 到 10/6 衝到整個月的最高峰。那幾天剛好是部落格改版最密集的時候:十幾個 PR 合併,包括幾篇新文章、Projects 版面重做、把 Projects 收進 /blogs/、新增系列頁。新網址一多、sitemap 一變,Meta 就大量重爬。不過這只是時間吻合,不能證明因果。
文章的佔比
觀察:真正的文章只佔 2% 的請求。
最常被爬的單一路徑是 /sitemap.xml,30 天 452 次。sitemap 是爬蟲的入口清單,而前一篇健檢剛好把它從 294 個網址瘦身到 137 個。
把路徑歸類之後更明顯:真正的文章 /blogs/* 只有 411 次請求,大約佔 2%。這個量和舊 favicon、主題範例文字網址、漏洞掃描差不多。爬蟲大部分的力氣花在雜項、圖片和錯的網址上。
自己造成的 404
觀察:一半的請求失敗,但多半是網站自己給錯網址,不是被擋。
| 狀態碼 | 請求 | 比例 |
|---|---|---|
| 404 找不到 | 9.48k | 94% |
| 405 方法不允許 | 250 | 2% |
| 401 需要驗證 | 196 | 2% |
| 403 被拒絕 | 167 | 2% |
| 499 用戶端斷線 | 51 | <1% |
403 只有 167 次,所以不是被 Cloudflare 擋掉,是網站自己給了爬蟲錯的網址。最常 404 的路徑:
| 路徑 | 是什麼 |
|---|---|
/favicon-16x16.png、/favicon-32x32.png | 舊的 favicon 路徑,現在的檔案在 /images/ 底下 |
/<link or path of image for opengraph, twitter-cards> | PaperMod 設定檔的範例文字,被當成分享圖網址 |
/<link / abs url> | PaperMod 設定檔的範例文字,被當成 favicon 網址 |
/.env、/service_account.json、/firebase-adminsdk.json、/.profile、/wp-config.php.bak | 漏洞掃描 |
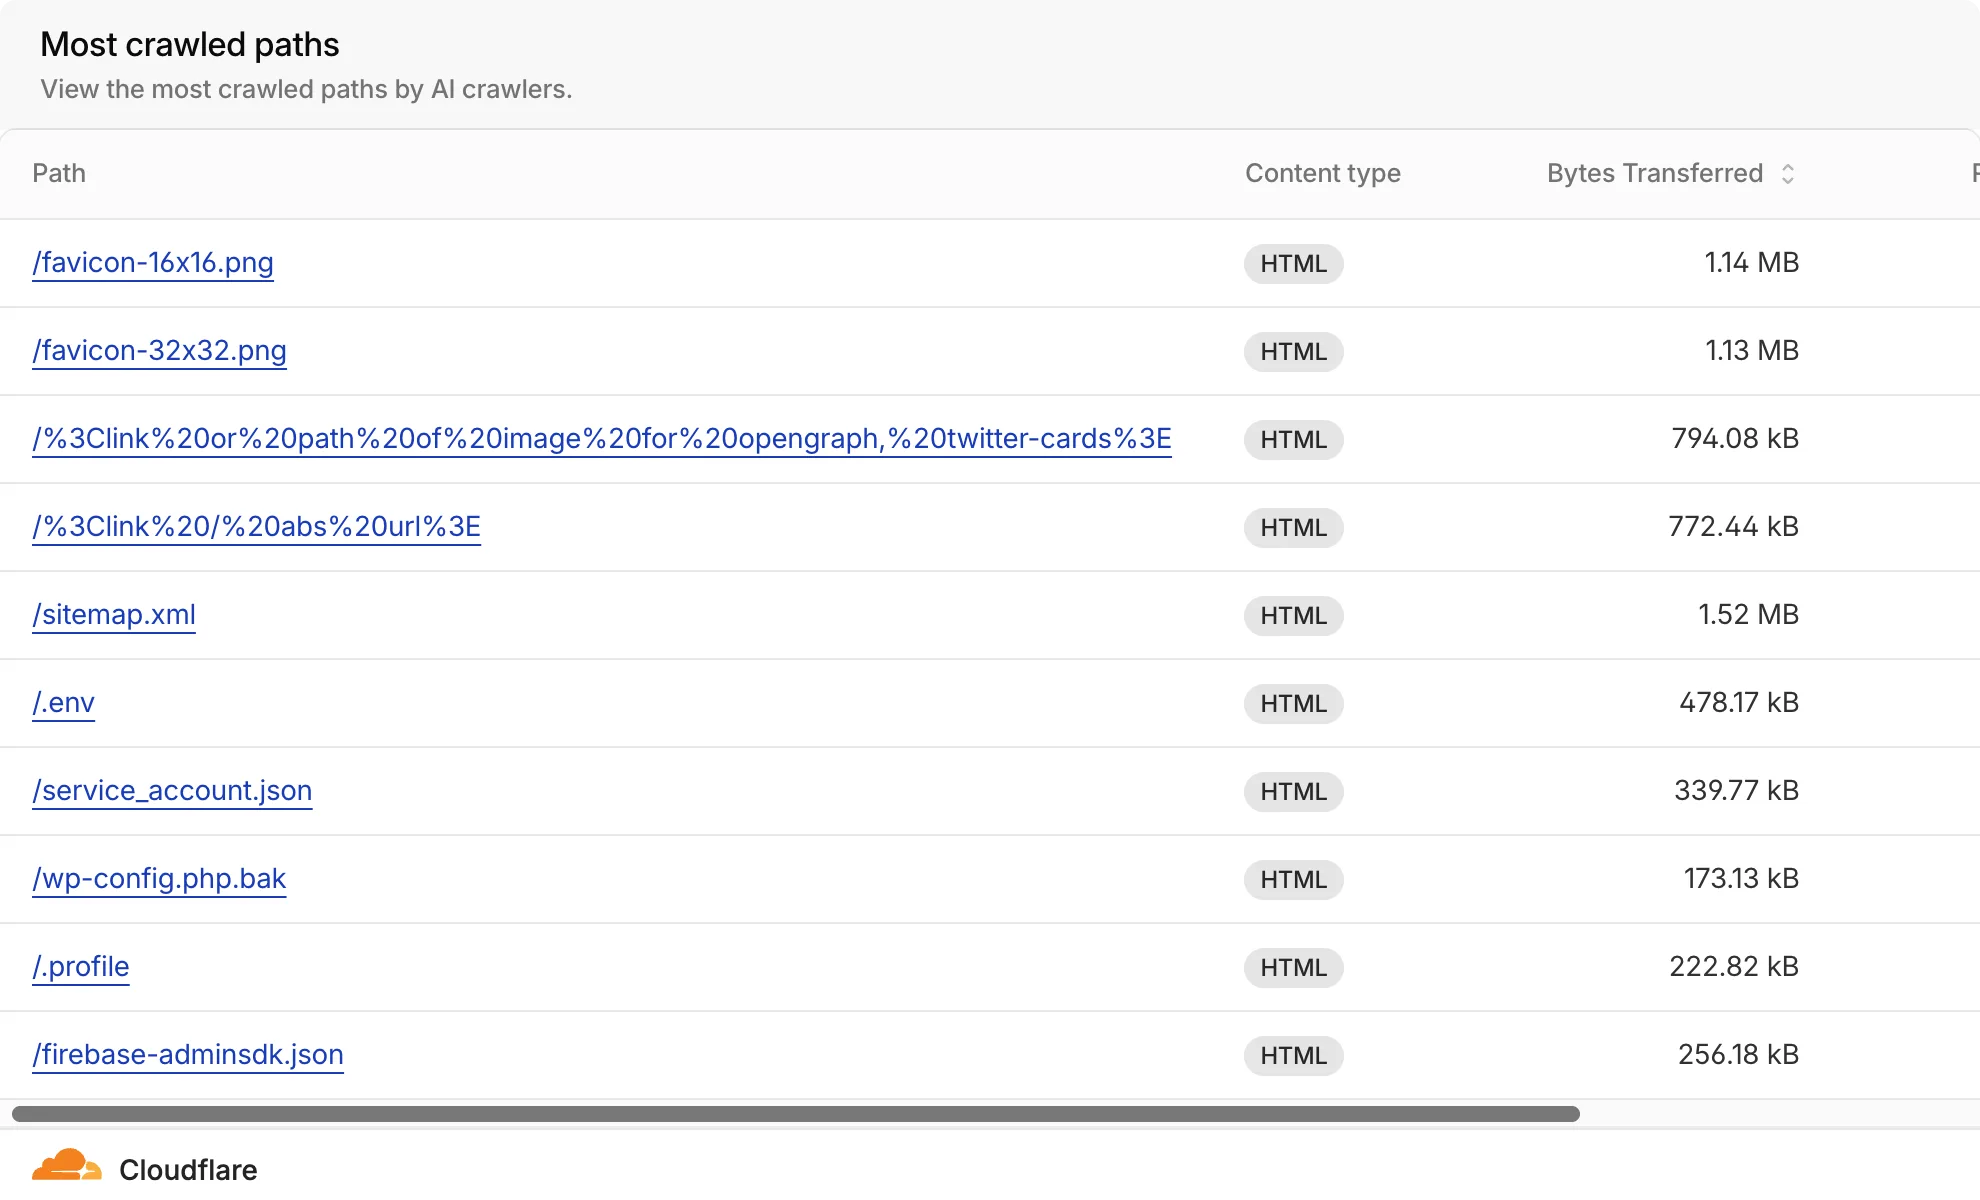
中間兩行最好笑。PaperMod 的 hugo.yml 範例裡,分享圖和 favicon 的欄位寫的是「請填網址」的提示文字。我一直沒換掉,網站就把這段提示原樣輸出成網址,爬蟲照著去抓,當然 404。這在 9/28 已經修掉,但爬蟲手上還留著舊網址,會繼續重試一段時間。
真人讀者看不到這種錯,只有爬蟲的數據會把它照出來。某種程度上,爬蟲替我做了一次免費的網站健檢。
冒名的 AI 助理
觀察:「AI 助理」類別的請求,幾乎全是冒名的漏洞掃描。
AI Assistant 這一類失敗率 91%,30 天只成功 36 次。一開始我以為是「有人在 AI 裡問到 kiwi-walk,AI 卻抓不到」,後來又猜是 AI 抓文章時順手抓 favicon 才失敗。把類別篩成 AI Assistant 之後,兩個猜測都錯了:
| 路徑 | 在找什麼 |
|---|---|
/configuration.php.bak | Joomla 設定檔備份,裡面有資料庫密碼 |
/firebase.json | Firebase 設定 |
/auth/.env、/site/.env、/api/v1/.env | 環境變數,通常放金鑰 |
/@fs/..%252f..%252f…/proc/self/environ | 透過 Vite 開發伺服器的 @fs 路徑穿越,讀伺服器的環境變數 |
/runtime-config.js | 前端執行期設定 |
/170j9agapco6pmunvdo9 | 一串隨機字,測網站對不存在的網址回什麼 |
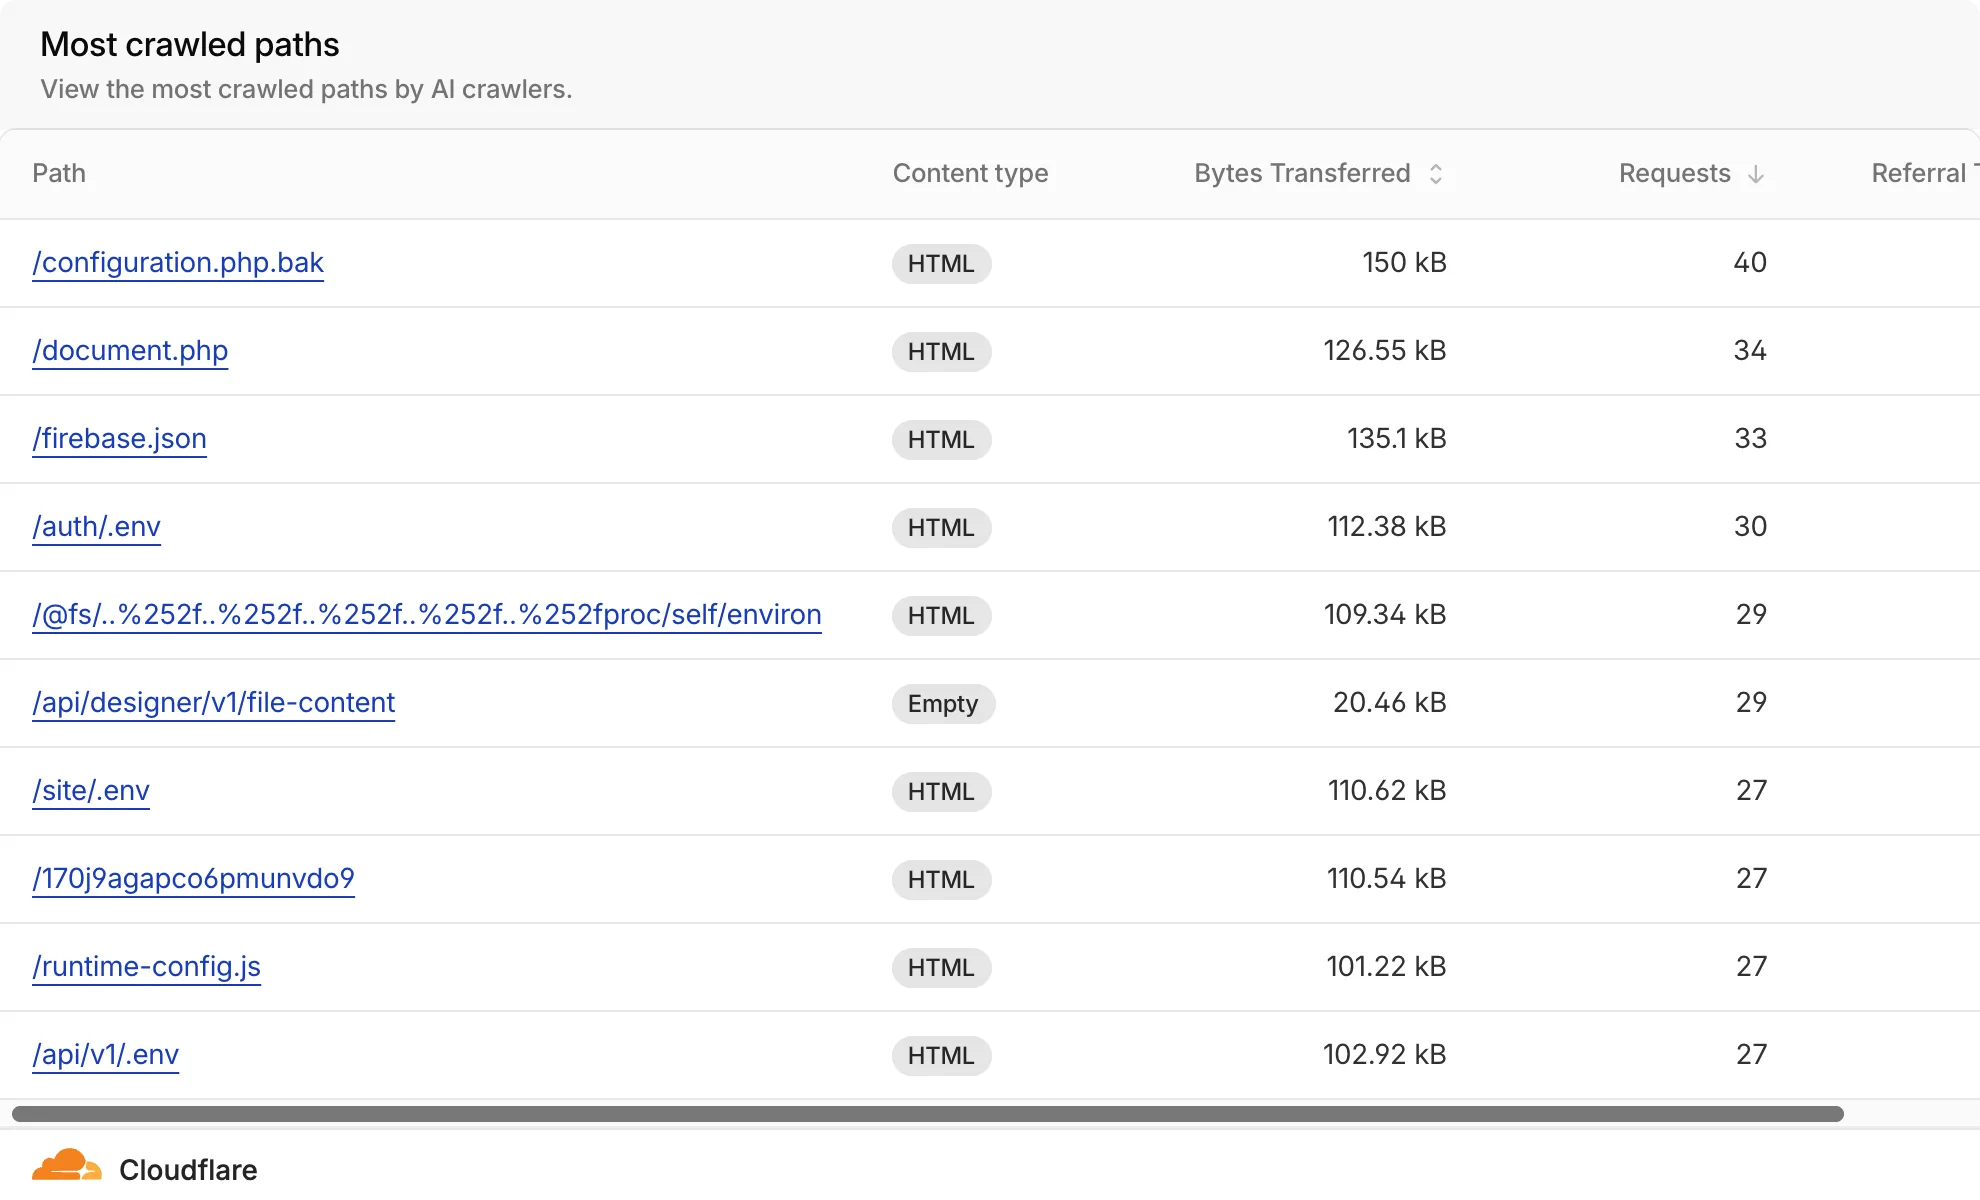
前 10 名沒有任何一篇文章,全是漏洞掃描。這些掃描器把自己的名字(User-Agent)換成 ChatGPT-User 這類 AI 助理。Cloudflare 免費方案只看這個名字認爬蟲,所以全被算進 AI Assistant。kiwi-walk 是 Hugo 靜態站,這些檔案本來就不存在,全部 404,沒有實際外洩風險。
所以 AI 流量的數字要打折看。尤其是 AI Assistant 這一類,照這個數字決定「放行 AI 助理」,等於放行一群用假名字的掃描器。
另外 Host 統計裡的 kiwi-walk.com:8443 不是我設的:Cloudflare 代理的網域本來就會在 8443 等幾個 HTTPS 埠回應,掃描器順便掃到。
Cloudflare 的 AI 優化頁
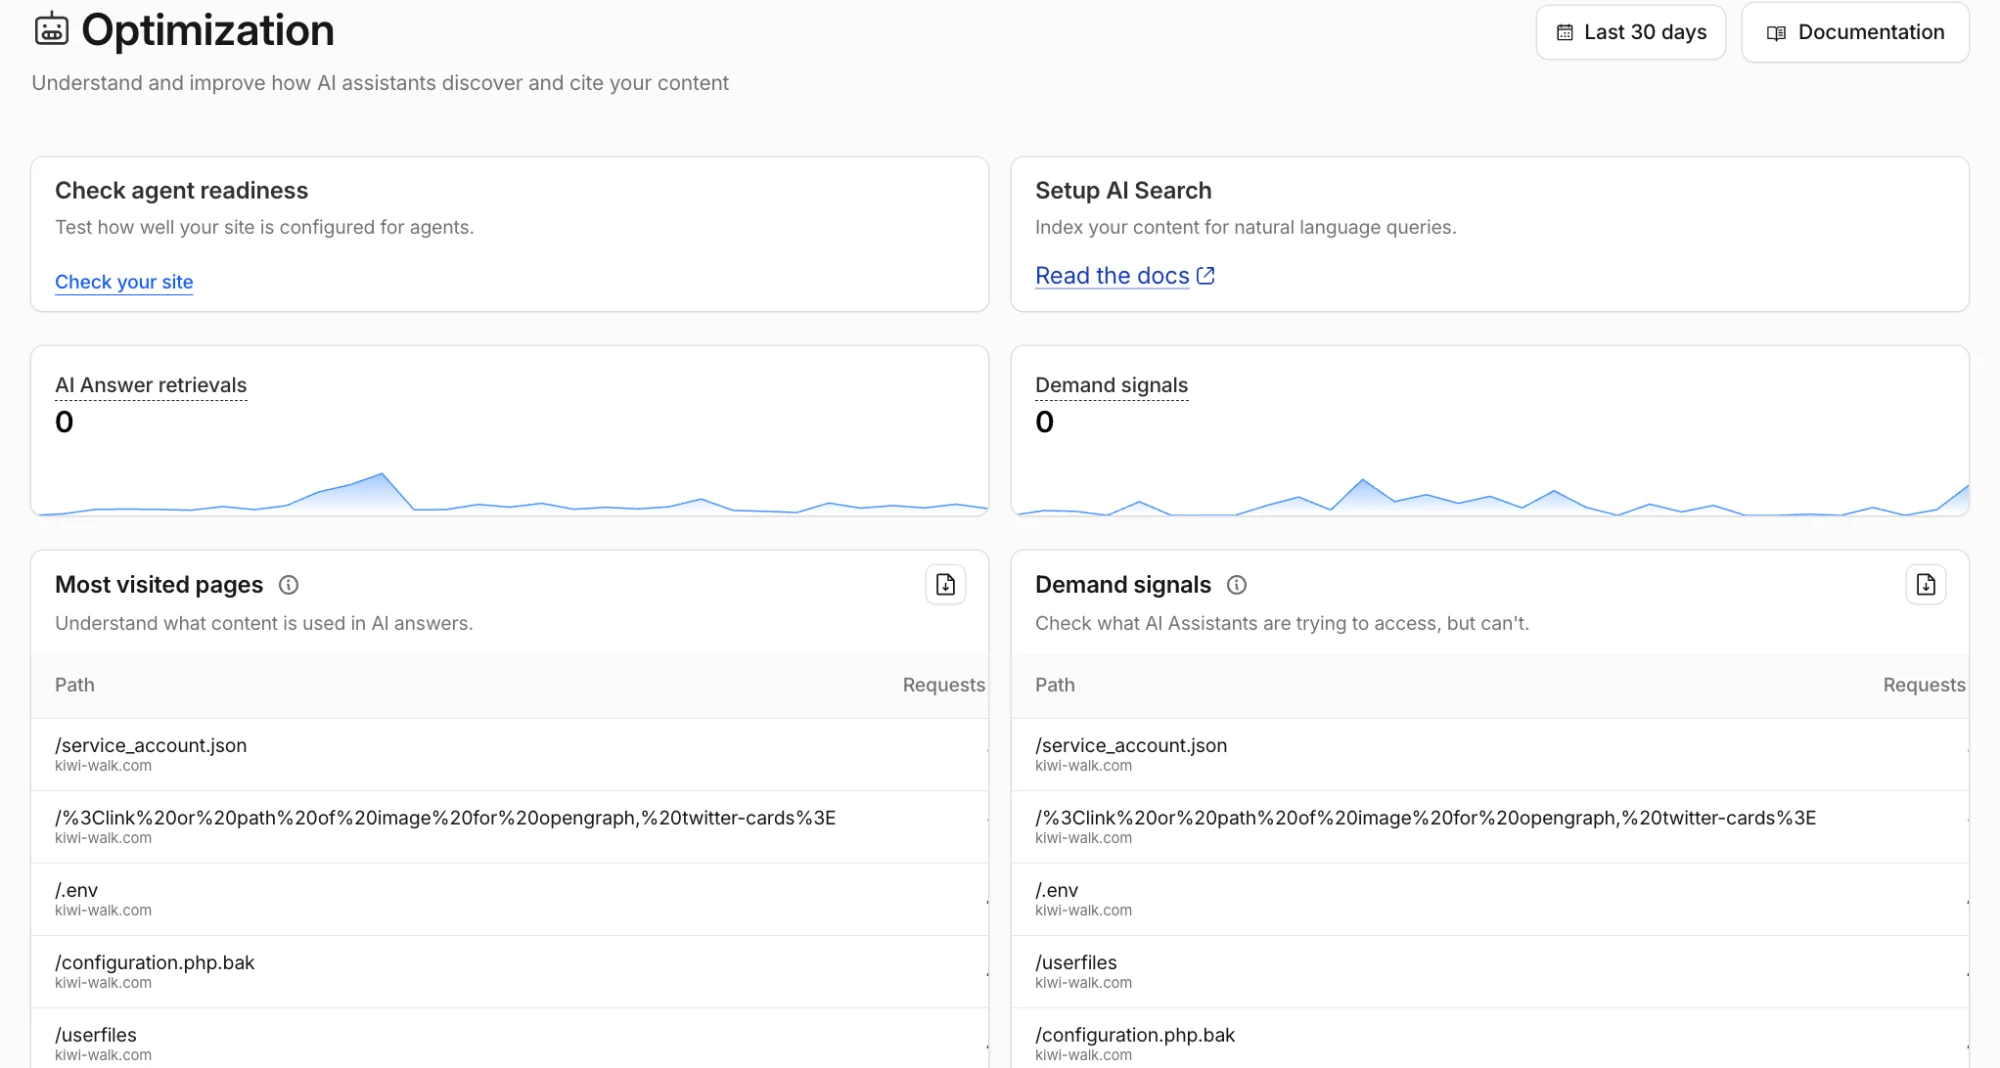
觀察:連 Cloudflare 自己的 AI 優化頁,也被冒名掃描灌了水。
Cloudflare 後台的 Optimization 頁,說是要幫你了解 AI 助理怎麼發現、引用你的內容。它列出來的「最常被用在 AI 答案的頁面」和「AI 想拿卻拿不到的內容」,卻是 /.env、/service_account.json、/configuration.php.bak。照這頁的建議去「優化」,等於把金鑰檔交出去。
這頁還有兩個大數字:AI Answer retrievals(被 AI 答案取用)和 Demand signals(AI 想拿卻拿不到)。30 天的檢視兩個都顯示 0,切到 7 天反而變成 1k 和 707,兩個時間範圍對不起來。7 天的清單依舊是 /userfiles、/__vite_rsc_findSourceMapURL、/@fs/app/.env.local、/services/.env 這類掃描,只有一個 CSS 檔是網站真的有的資源。這兩個數字一樣是照名字分類算出來的,裡面大部分應該是冒名的掃描器,不能當成「AI 引用了我幾次」。
設定與決定
Cloudflare 的四類爬蟲,擋掉的代價各不相同:
| 類別 | 代表 | 爬了做什麼 | 擋掉的代價 |
|---|---|---|---|
| AI Crawler | GPTBot、ClaudeBot、Meta-ExternalAgent | 訓練模型 | 網站不會因此少流量 |
| AI Search | OAI-SearchBot、PerplexityBot | 建 AI 搜尋的索引,答案會附連結 | 從 ChatGPT 搜尋、Perplexity 的引用裡消失 |
| AI Assistant | ChatGPT-User、Claude-User | 使用者提問時即時抓頁 | 有人指名問到你的文章時,AI 讀不到 |
| Search Engine | Googlebot、Bingbot | 傳統搜尋 | 從 Google、Bing 消失 |
傳統搜尋和 AI 搜尋才會帶讀者回來,訓練爬蟲只拿不給,所以一般的建議是擋訓練、放搜尋和助理。Cloudflare 的設定在 Security Settings 的 Configure AI bot policies,分成 Search、Agent、Training 三組,每組可以選全站封鎖、只在有廣告的頁面封鎖,或放行。舊的「Block AI bots」開關已經在 2026-09-15 開始淘汰。
這個月三組都是 Allow:
我的決定是維持全放。我希望 AI 盡量爬,只擋 .env 這類惡意的爬取。4xx 查下來,大部分失敗是自己的設定和舊網址造成的,該做的是修,不是擋。
擋掃描不看爬蟲名字,因為掃描器會冒名;改看它要什麼。Hugo 靜態站不會有 .env、.php、/@fs/,要這些東西的請求,不論掛什麼名字都是惡意。做法是 Cloudflare 免費方案的 WAF 自訂規則(Security → WAF → Custom rules),動作選 Block:
(http.host in {"kiwi-walk.com" "www.kiwi-walk.com" "cdn.kiwi-walk.com"}) and (
  http.request.uri.path contains "/.env" or
  http.request.uri.path contains ".php" or
  http.request.uri.path contains "/.git" or
  starts_with(http.request.uri.path, "/@fs/") or
  http.request.uri.path contains "/proc/self" or
  http.request.uri.path contains "service_account" or
  http.request.uri.path contains "firebase" or
  http.request.uri.path contains "runtime-config" or
  http.request.uri.path contains "/userfiles"
)
- 只套在主站、www 和 CDN。另一個子網域是我自己 9 月底上線的服務,不套,避免擋到它的 API。
- 檢查過 blog repo 的
content/、static/,沒有任何路徑含上面的字串,不會擋到文章。 /api/*沒有列進去:主站目前沒有 API,但之後可能會有。- 這些路徑本來就是 404。擋的效果是在 Cloudflare 邊緣直接回 403,不再打到 Pages,AI 流量的統計也會變乾淨。