今天要解的問題
我從來沒特別理會過 kiwi-walk,之前只有掛 GA, GOOGLE SEO,其他就沒了。因此想要來鑽鑽 SEO,讓他至少先用 AI 順過一遍。
範圍三個方向:
- 現況健檢加一份改善清單
- 在意的流量來源是 Google 台灣繁中、AI 搜尋(ChatGPT、Perplexity、AI Overviews)、英文搜尋
- 直接動手改
網路上似乎有過多的 SEO 探討,許多的必做清單多是個人經驗。所以就請 claude 將這些探討拆成一條條可以驗證的主張、去對官方文件,再回頭看看要補什麼在網站上。
想法與取捨
先查證:哪些有證據,哪些沒有
查證方式是從五個方向搜尋、抓 24 個來源,抽出 118 條主張,其中 25 條逐條由三個獨立檢查各投一票,要三票中有兩票反駁才算推翻。留下來、跟這個網站有關的結論:
| 主張 | 結果 |
|---|---|
| 結構化資料影響排名 | 否。只影響搜尋結果怎麼呈現(標題、圖片、日期) |
| 文章的作者要標成 Person 並連到可辨識的頁面 | 是,Google 文件明說,但從沒說這是排名訊號 |
| 轉址、canonical、sitemap 要指向同一個網址 | 是,三個訊號互相加強,不一致時 Google 只能猜 |
| 擋 GPTBot 就不會出現在 ChatGPT 搜尋 | 否。搜尋看的是 OAI-SearchBot,GPTBot 只管訓練 |
| 寫成問答格式比較容易被 AI 引用 | 唯一一篇研究顯示反而略負,而且只是相關性 |
另外有一批題目完全沒查到可信證據:llms.txt 有沒有用、IndexNow 跟 ChatGPT 搜尋的關係、中英混排要不要 hreflang、標籤頁該不該 noindex。這幾項我都先不做,或者只依一般原則判斷,不當成已驗證的事。
標籤和分類頁:不收錄,但連結可以跟
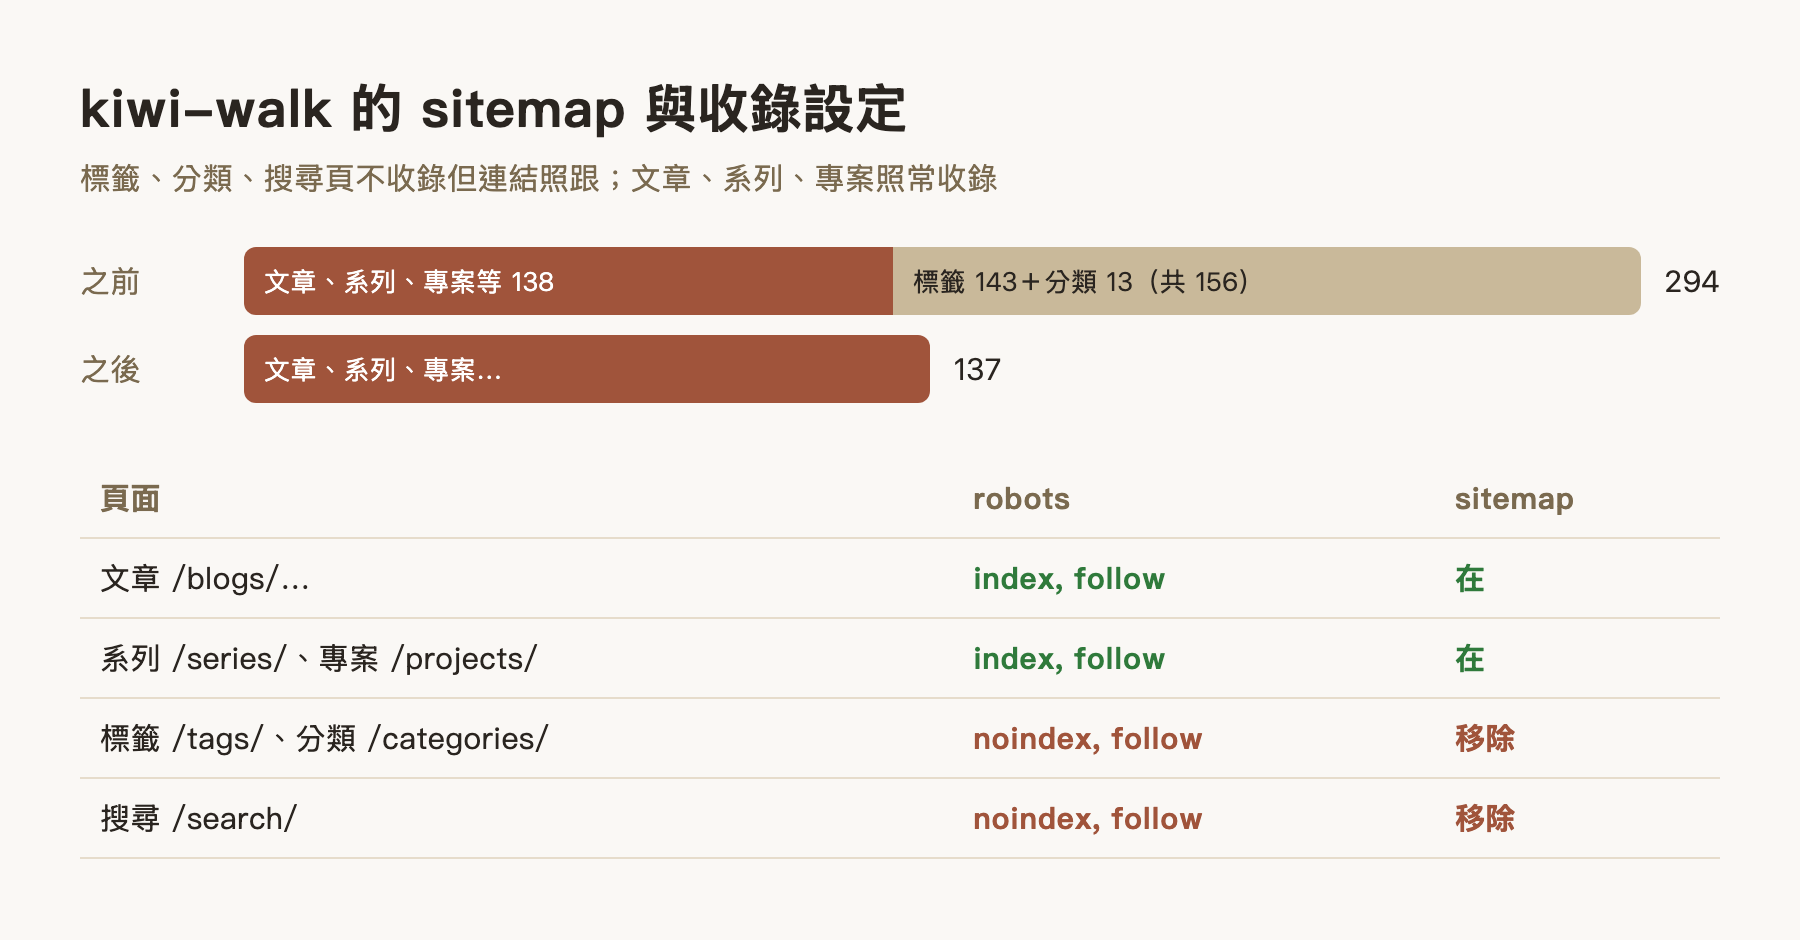
健檢時發現 sitemap 有 294 個網址,其中 143 個是標籤頁、13 個是分類頁,比文章還多。
一開始我選了「不收錄、移出 sitemap」,之後又回頭問了一次:
標籤頁和分類頁和系列出現在搜尋結果,會有怎樣的優缺點
但這題沒有查到直接證據,所以 claude 是拿網站自己的數字判斷:
- 142 個標籤裡 101 個只有 1 篇文章。這種頁面的內容就是那一篇的標題加摘要,搜到它的人還要多點一次才看到文章,它甚至可能跟文章本身搶同一個關鍵字。
- 分類頁
/categories/engineer/和分類主頁/blogs/engineer/列的文章幾乎一樣,後者還有封面和介紹。兩個網址內容相同,正本應該是後者。分類裡還混著2024、theater這種只有一篇的值。 - 每天發文,新文章能不能快點被爬到比較重要。爬蟲的時間不該花在 150 多個清單頁上。
系列頁和專案頁就不一樣了,它們有我自己寫的介紹、有順序,是真的整理頁。最後的決定是「系列頁與專案頁可加入 index」,標籤、分類、搜尋頁不收錄。
不收錄不等於刪掉:頁面照常存在,讀者照樣能點。之後如果某個主題值得經營搜尋流量,開一個有介紹文字的系列頁,會比依賴自動產生的標籤頁好。
未來日期的文章:差點關掉
健檢還抓到 10 篇日期在未來的文章已經上線,sitemap 也列著未來的日期。原因是 hugo.yml 開了 buildFuture: true。我一開始回答「不是刻意的,關掉」,直到看到關掉的後果:
- Hugo 只在建置時決定要不要輸出一篇文章,Cloudflare Pages 只在 push 時建置,所以文章不會在日期到的那天自動出現。
- 每日筆記的日期是由 Day 編號推算的(
Day N = 2026-09-14 + N),常常排在實際發文日之後。關掉會讓已經上線的 Day29 到 Day38 暫時變成 404。
當時我問的是「文章不會自動出現嗎?身為作者,我可以看到嗎」。作者自己在本機用 hugo server -D -F 一樣看得到,但讀者手上的連結會壞。未來日期在 sitemap 裡的 SEO 代價很小,所以 buildFuture 維持開啟。
修改日期不從 git 推算
結構化資料建議提供 dateModified。Hugo 可以用 enableGitInfo 從最後一次 commit 推算,我本來也加了,build 出來才發現兩個問題:
- 這個 repo 常有一次改全部文章 front matter 的整理型 commit。用 git 推算,110 篇會同時顯示「剛修改」,這個訊號就沒意義了。
- 未來日期的文章,最後一次 commit 在發布日之前,會出現「修改日早於發布日」的資料。
所以拿掉,dateModified 只看文章自己寫的 lastmod,沒寫就等於發布日。
結構化資料:主體是我,不是一間公司
PaperMod 預設把網站當成 Organization,發布者的 logo 用 favicon.ico。這是一個人的部落格,Google 對作者標記的建議又是「Person,加上能唯一辨識這個人的頁面」,所以作者和發布者都改成同一個 Person:連到 About 頁,sameAs 列出 Medium、GitHub、Instagram、LinkedIn,email 不放(mailto: 不是可辨識的頁面)。首頁另外輸出 WebSite。
麵包屑在 2025 年初已經從手機版搜尋結果消失,只剩桌機顯示,但 Google 還支援,就留著,順便補上「首頁」這一層。
實作
用 cascade 一次設定所有標籤與分類頁
標籤頁是 Hugo 自動產生的,沒有對應的 Markdown 可以寫 front matter。config 層級的 cascade 可以用路徑挑頁面,把 front matter 灌進去:
# Tag and category pages are thin lists: keep them for readers, out of the
# index and the sitemap. Series and section pages stay indexed.
cascade:
  - locale: zh_TW
  - _target:
      path: "{/tags,/tags/**,/categories,/categories/**}"
    robotsNoIndex: true
    sitemap:
      disable: true
robotsNoIndex 是 PaperMod 讀的參數,sitemap.disable 是 Hugo 內建的 sitemap 讀的。路徑同時寫 /tags 和 /tags/**,前者是標籤總覽頁、後者是各個標籤頁。搜尋頁是一般頁面,直接在它的 front matter 寫同樣兩個欄位。第一行的 locale 是另一件事,下面「踩到的坑」會講。
noindex 但 follow
PaperMod 的 head.html 碰到 robotsNoIndex 會輸出 noindex, nofollow。這個判斷寫在 head.html 中間,只能整份複製到 layouts/partials/ 再改這一段:
{{- if not (hugo.IsProduction | or (eq site.Params.env "production")) }}
<meta name="robots" content="noindex, nofollow">
{{- else if eq .Params.robotsNoIndex true }}
<meta name="robots" content="noindex, follow">
{{- else }}
<meta name="robots" content="index, follow">
{{- end }}
非正式環境照舊什麼都不給爬,標籤頁則是「這頁不要收,但上面的連結可以跟」。主題的版本是鎖定的,複製一份不會遇到主題更新的衝突。
結構化資料
在 layouts/partials/templates/schema_json.html 覆寫主題的版本。先組一個所有頁面共用的作者:
{{- $sameAs := slice }}
{{- range site.Params.socialIcons }}
  {{- if not (hasPrefix .url "mailto:") }}{{ $sameAs = $sameAs | append (trim .url " ") }}{{ end }}
{{- end }}
{{- $lang := site.LanguageCode }}
{{- $person := dict
  "@type" "Person"
  "name" site.Params.author
  "url" ("about/" | absURL)
  "image" ("images/avatar.jpg" | absURL)
  "sameAs" $sameAs
}}
社群連結直接沿用 hugo.yml 裡顯示在首頁的那份 socialIcons,不用另外維護一份清單。
文章用 dict 組好再 jsonify,不再像主題那樣手拼 JSON 字串,引號與跳脫交給 Hugo:
{{- if and .IsPage (eq .Section "blogs") (not .Date.IsZero) }}
{{- $post := dict
  "@context" "https://schema.org"
  "@type" "BlogPosting"
  "headline" (.Title | plainify)
  "description" (or .Description .Summary | plainify | htmlUnescape)
  "keywords" (.Params.keywords | default .Params.tags | default slice)
  "wordCount" .WordCount
  "inLanguage" $lang
  "datePublished" (.PublishDate.Format "2006-01-02T15:04:05-07:00")
  "dateModified" (.Lastmod.Format "2006-01-02T15:04:05-07:00")
  "author" $person
  "publisher" $person
  "mainEntityOfPage" (dict "@type" "WebPage" "@id" .Permalink)
}}
{{- with .Params.cover.image }}
  {{- $img := cond (eq $.Params.cover.relative true) (path.Join $.RelPermalink .) . }}
  {{- $post = merge $post (dict "image" (absURL $img)) }}
{{- else }}
  {{- with index (partial "partials/templates/_funcs/get-page-images" .) 0 }}
    {{- $post = merge $post (dict "image" .Permalink) }}
  {{- end }}
{{- end }}
<script type="application/ld+json">{{ $post | jsonify | safeJS }}</script>
{{- end }}
第一行的條件是 build 完檢查輸出才補上的,原因在下一段。主題原本還把整篇文章的純文字塞進 articleBody,那不是建議欄位,卻讓每頁的 <head> 多了一整篇文章的大小,這裡拿掉了;wordCount 也從字串改成數字。
文章封面不要延遲載入
文章頁最大的那張圖通常就是封面,它決定 LCP(最大內容繪製)有多快。站上覆寫過的 cover.html 把所有封面都設成 loading="lazy",連文章頁頂端那張也是,瀏覽器會等排版完才去抓它。改成文章頁的封面立刻載入並提高優先權,列表的縮圖維持延遲:
{{- /* A post's cover is its LCP image: load it eagerly; list thumbnails stay lazy. */}}
{{- $loading := cond (eq $.IsSingle true) `loading="eager" fetchpriority="high"` `loading="lazy"` | safeHTMLAttr }}
三個 <img> 原本寫死的 loading="lazy" 都換成 {{ $loading }}。
預設分享圖
沒有封面的文章,分享到社群時用的是 hugo.yml 的 images,原本是一張方形 logo。社群卡片要的是 1.91:1,方形圖會被裁掉一大塊。重做了一張 1200×630 的,放上 CDN:
踩到的坑
分享圖網址被拼成兩段
一篇書評的 og:image 長這樣:
https://kiwi-walk.com/blogs/books/fake_news_…/https:/cdn.kiwi-walk.com/content/posts/books/…/images/3.png
封面早就搬到 CDN、是完整網址,但 front matter 還留著當初本機圖片時代的 relative: true。主題看到 relative 就把封面路徑接在文章網址後面,結果是一個不存在的網址,分享卡片、Twitter 卡片、結構化資料三處同時壞掉。拿掉 relative 就好。全站只有這一篇這樣寫,另一篇有 relative 的是 false,沒事。
驗證標籤裡填的是 GA 追蹤碼
每頁 <head> 都有一行 google-site-verification,內容是 G- 開頭的 Google Analytics 追蹤碼。這兩個東西用途完全不同:GA 追蹤碼是送出瀏覽數據用的,Search Console 的驗證碼是 Search Console 另外發的一長串字,用來證明你擁有這個網站。拿 GA 追蹤碼去填驗證欄位,標籤等於空放著。
GA 追蹤本身沒受影響,因為它是另一個設定。處理方式是把這行拿掉,Search Console 要驗證就改用 DNS TXT 記錄,不依賴模板。
同一個語言代碼,三個地方要三種格式
為了讓 og:locale 輸出 Open Graph 要的 zh_TW(底線),我把 languageCode 設成 zh_TW。實作完重讀一次輸出才發現,同一個值還被兩個地方讀:
- RSS 的
<language>變成zh_TW,但 RSS 要的是zh-TW(橫線) - 結構化資料的
inLanguage一樣要橫線
PaperMod 的 opengraph 模板會先讀頁面的 .Params.locale,再退回 languageCode。所以 languageCode 改回 zh-TW,og:locale 改由 cascade 對每頁給 locale: zh_TW,三個地方各拿各的格式。
「關於我」被標成部落格文章,日期是西元 1 年
主題對每一個單頁都輸出 BlogPosting。「關於我」、搜尋頁、文章總覽頁沒有日期,結構化資料裡的發布日期就成了:
"datePublished":"0001-01-01T00:00:00+00:00"
第一次修正只限定 /blogs/ 底下的頁面,再 build 一次又抓到 blogs/art/list。它在 /blogs/ 底下,卻是一個 archives 版面的清單頁,同樣沒有日期。所以條件最後是「在 /blogs/ 底下,而且有日期」,修完剩下 108 篇文章帶 BlogPosting,沒有一篇是西元 1 年。
favicon.ico 其實是 469 KB 的 PNG
主題的 <head> 會引用 16、32 像素的 PNG favicon 和 180 像素的 apple-touch-icon,這三個檔案都不存在,全部 404。順手查 favicon.ico,發現它是吉祥物原圖改了副檔名,469 KB。補上三個尺寸的 PNG,ico 重做成真正的多尺寸格式,剩 15 KB。
小結
這次健檢做到的事:
- sitemap 從 294 個網址降到 137 個,只剩文章、系列、專案這些有內容的頁面
- 標籤、分類、搜尋頁不收錄,但連結照跟
- 結構化資料改成以作者本人為主體,西元 1 年的假文章不見了
- 一張壞掉的分享圖、一個無效的驗證標籤修好了
- 文章封面不再延遲載入
有兩件事在 repo 裡做不到,要到 Cloudflare 後台設定:
- 正式的
kiwi-walk.pages.dev會完整提供整站內容,等於一份重複的網站,要 301 轉到正式網域。 - AI 爬蟲的封鎖開關要確認沒有擋到 OAI-SearchBot 和 PerplexityBot。
這次最實用的判斷,是先分清楚哪些建議有證據。結構化資料、轉址一致性、AI 爬蟲分流這些有官方文件可以對。llms.txt、問答格式這些聽起來很合理,卻查不到證據,就先不花時間。另一個判斷是不把 SEO 的建議直接套到這個網站上:關掉未來日期、從 git 推算修改日期,在一般部落格都是合理的建議,套到「每天發文、日期由編號推算」的每日筆記上就會出問題。