今天要解的問題
llm-wiki 是我用 Obsidian 加 Claude Code 維護的個人知識庫:筆記放在 git repo 裡,整理、分類、建頁都交給一組 skill 做。Day31 做了 /claude-doctor,定期檢查這些 skill、CLAUDE.md 和 hook 還適不適合目前的模型,只報告、不自己改設定。
它第一次正式跑完,交出的是 7 條「應改」(🔴,會造成錯誤行為)、17 條「建議」(🟡,品質與 context 成本)和 4 條值得採用的新做法。報告只列問題,接下來的修正輪才是真的工作。我丟給 Claude 的指令就一句:
claude doctor fix
修正輪做到一半,問題就從「修哪幾條」變成三件更根本的事:
- 報告本身該放在哪裡,才能讓修正輪和下一次健檢接得上
- 有些 🔴 是在修根本沒在用的 skill
- 🟡 裡最大的一條:負責內容健康的
/vault-maintain每次都重寫自己的掃描腳本,修完還要再派 agent 覆核
想法與取捨
報告放哪:GitHub 上的說明、research-notes,還是一次一檔
一開始報告只存在一個地方:健檢那次送到 GitHub 給我審的變更說明。修正輪開工時,Claude 先在 repo 裡找報告,log 只有一行「7 應改 / 17 建議 / 4 新做法」,最後是回 GitHub 把那份說明抓回來,才知道 🔴1–7 是哪幾條。報告不在 repo 裡,修正輪就得記得去哪裡撈。
修到一半我提出第一個要求:
請修改 skill,讓結果產出落在 [[research-note.md]] 裡面
research-notes.md 是 doctor 每次研究完寫下的指引摘要,裡面有「官方」「社群」「已採用」「評估過不採用」四區。第一版就照做:報告寫在這個檔的檔尾,修正輪在每條前面標 ✅ 已修。
接著我又提了一個問題:
然後現在 research-notes.md 區塊有點問題,重複的已採用與評估過不採用的區塊 請確認目前的格式是適合不斷的疊加,或是統一放在 @log 內部,然後每次一個檔案存放
Claude 回頭檢查,標題其實沒有重複,真正的問題是同一件事記了三次。以「根目錄加 .worktreeinclude」這個修正為例,它同時出現在 research-notes 的「已採用」區、報告區的 ✅ 已修,以及月 log 的修正輪條目。「已採用」原本是用來記「哪條外部指引我們採用了」,這一輪被寫成了 changelog。照這個格式,每跑一次 doctor research-notes 就多長一整段報告。
最後依「會活多久」拆開:
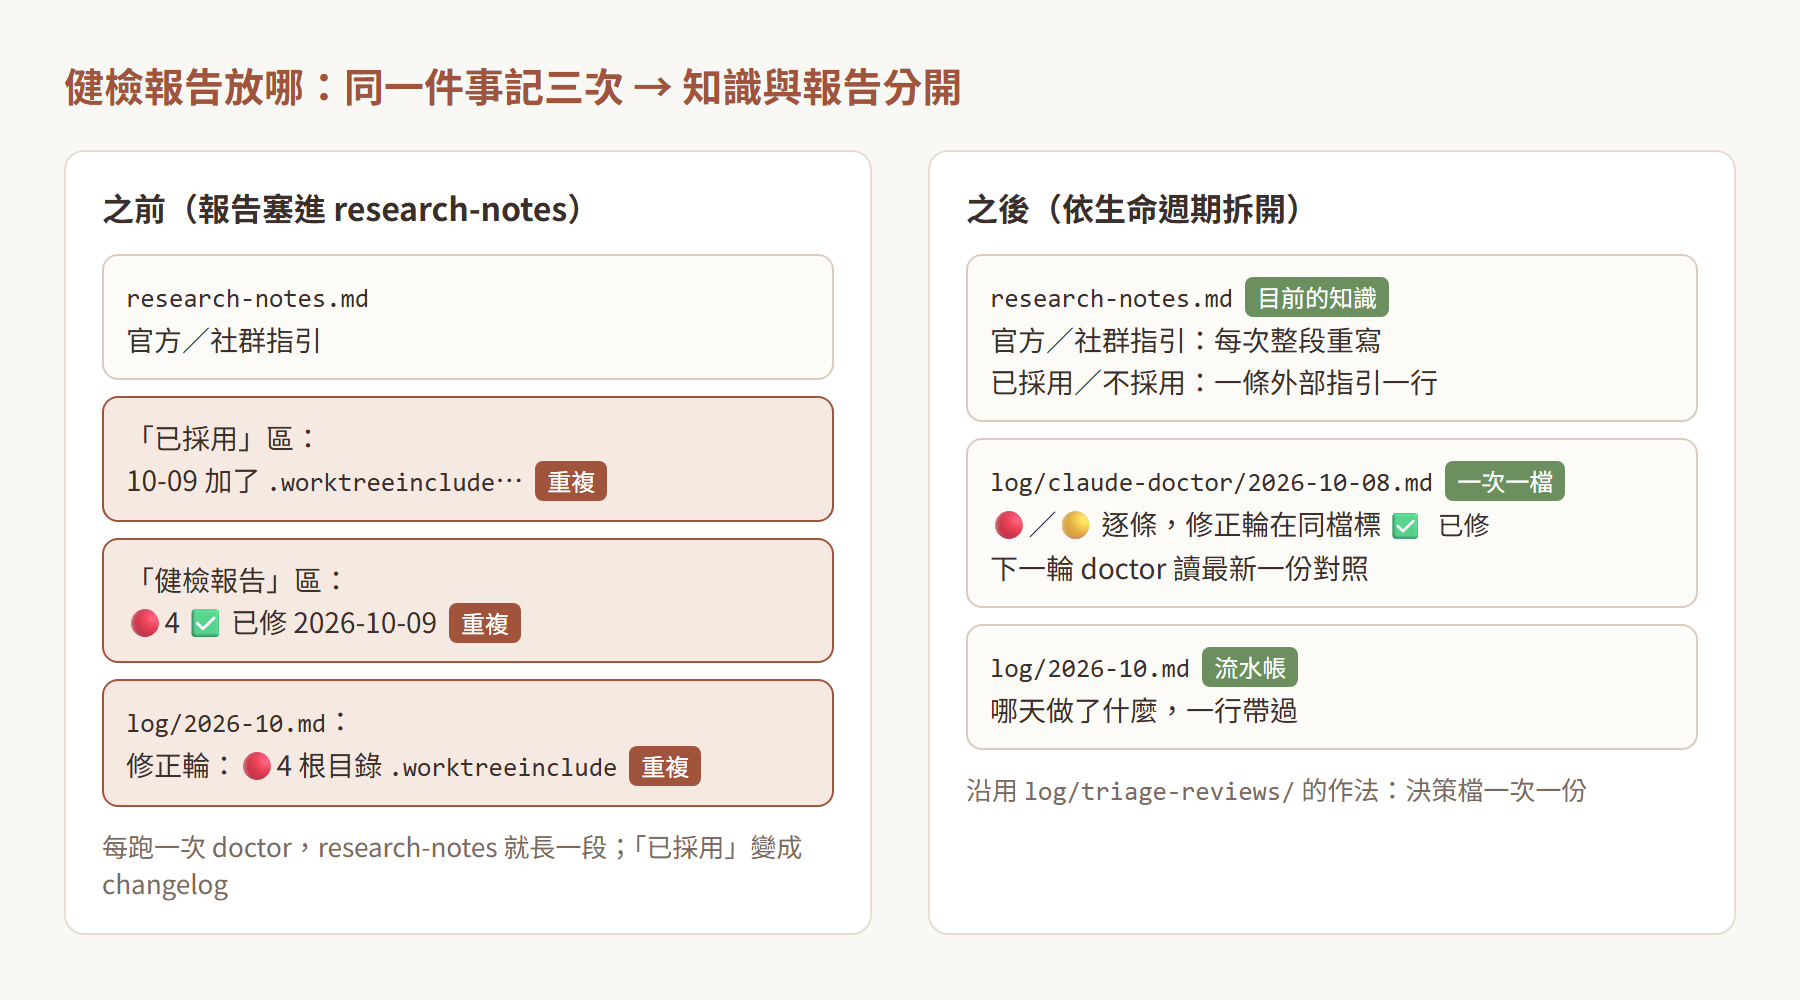
research-notes.md只放目前的知識:官方/社群指引每次整段重寫,「已採用/不採用」一條外部指引一行- 報告改成
log/claude-doctor/YYYY-MM-DD.md,一次健檢一個檔,修正輪在同一個檔標已修 - 月 log 照舊,一行記哪天做了什麼
一次一檔是沿用 vault 裡 /inbox-triage 的做法:它的決策檔本來就放 log/triage-reviews/,一次一份。
修好它,還是刪掉它
🔴4–6 都落在幾個很少用的 skill 上:匯出財務 app 資料、產 Threads 圖卡、產 Medium 封面、渲染 Marp 投影片。🔴4–5 是同一類:vault 改成每個 session 都在 git worktree 裡工作之後,這些 skill 要讀的 gitignored 檔(API key、財務 app 匯出的 SQLite)在 worktree 裡不存在,圖卡與封面也輸出到會被清掉的 worktree 裡。🔴6 是投影片的 frontmatter 少了 title,寫檔時會被 hook 擋下。
Claude 照報告修了:加 .worktreeinclude 讓 worktree 建立時複製那些檔、輸出改寫回主 checkout、投影片模板補欄位。修完我說:
我想要刪除沒再用的 skill
列了 5 個,稍後又補一個:
@.claude/skills/medium-cover 這個 skill 也不需要了
6 個 skill 連同它們專用的模板一起刪,兩個 commit 合計少了一千七百多行。🔴4–6 剛加上的修正也跟著拿掉,.worktreeinclude 只剩 .env.local 一行、而它唯一的使用者就是 medium-cover,所以整個檔也刪了。報告裡這三條最後標的是「隨 skill 一起移除」。
刪之前要先處理的是引用:medium-cover 有一步寫「同 /threads-cards 流程 1-3 步」,threads-cards 一刪,那三步(slug 規則、類型偵測、IG handle 順序)就斷了,所以先把它們搬進 medium-cover,下一輪又連 medium-cover 一起刪。
驗證要多重:每筆派 agent,還是重跑 lint
🟡1 是報告裡分量最重的一條,講的是 /vault-maintain。它原本的流程有兩個問題。
第一,機械檢查(frontmatter 缺欄位、斷連結、index 漏條目…)每次都現寫:
寫一支唯讀 Python 腳本放 scratchpad(不放 vault 內——根目錄規則與 hook 會擋),按上方規則表逐條掃描
規則表是固定的,腳本卻每次重寫。兩台機器(Windows 和 Mac)各寫各的,跑出來的數字不保證一樣。
第二,--apply 自動修完之後,每一批都派一個 agent 對抗式覆核:
派 1 個 sonnet subagent 對抗式驗證整批:「每筆是否正確、是否丟失資料?預設懷疑、傾向 fail。實際讀檔,不信宣稱。」
doctor 的研究那一步查到,目前的模型本身就會自我驗證,舊 prompt 留下的驗證指令會變成過度驗證;報告的原話是「雙倍成本」。可是修補種類差很多:補 index 條目、把全路徑連結改短,修錯了重跑檢查就看得出來;刪過期的 triage 決策檔、清掉舊 worktree 和分支,刪錯就是資料不見。
最後的做法是兩件事一起改:掃描腳本入庫成 scripts/lint.py,驗證改成修完重跑它;只有三種刪除類修補保留 reviewer。
實作
報告格式寫進 skill
/claude-doctor 的 Phase 3 改成寫新檔,並規定修正輪怎麼標記:
## Phase 3 — 報告(`log/claude-doctor/YYYY-MM-DD.md`)

一次健檢一個新檔,舊報告不改寫也不刪(每月一份,量小,全留)。動筆前先讀 `log/claude-doctor/` 裡最新的一份:
標了 `✅ 已修` 的條目若這次稽核沒再出現就不再列;沒修、這次又發現的照常列,在句尾註「(上次已列)」,
讓使用者看出哪些拖了不止一輪。
「上次已列」是這個格式真正的用處:報告一次一檔、修正狀態寫在檔裡,下一次健檢讀最新一份,就分得出哪些是新問題、哪些拖了好幾輪。標記規則也寫在同一段:修完標 ✅ 已修 YYYY-MM-DD、決定不修標 ⏭ 不修:{理由},條目不刪。
lint.py:一支腳本取代每次現寫
.claude/skills/vault-maintain/scripts/lint.py,421 行,純 Python 3、沒有依賴,跟同目錄另外兩支刪除用的腳本放在一起。它涵蓋規則表上 E1–E7、W1–W5、I1–I4 的機械檢查,再加上衝突副本、log 命名、hub 候選 tag 的統計,輸出可以是人看的清單或 --json。全 vault 跑一次約 1.7 秒。
下面三段是它比「照規則表直譯」多出來的地方,都是第一次跑全 vault 時才補上的。
用 git 的最後 commit 時間判斷 raw 有沒有閒置,而不是檔案 mtime:
def git_last_commit_times(root: Path) -> dict[str, int]:
    """path -> unix time of the last commit touching it (mtime is checkout time in git, useless)."""
    try:
        out = subprocess.run(["git", "-c", "core.quotepath=false", "-C", str(root), "log", "--format=@%ct", "--name-only", "--no-renames"],
                             capture_output=True, text=True, encoding="utf-8", check=True).stdout
    except Exception:
        return {}
    times: dict[str, int] = {}
    cur = 0
    for line in out.splitlines():
        if line.startswith("@"):
            cur = int(line[1:])
        elif line and line not in times:
            times[line] = cur
    return times
一次 git log 掃完整段歷史,每個路徑只記第一次看到的時間,也就是最新那次 commit。W5「raw 孤兒」原本的規則是「mtime > 30 天」,但 vault 搬進 git 之後,mtime 只是 checkout 的時間。
連結解析的兩個慣例:
    def resolve(self, target: str) -> list[Path]:
        """Paths a wikilink target can mean. Path-qualified links resolve by path; bare names by basename."""
        t = target.strip().rstrip("\\")  # `[[x\|alias]]` inside tables escapes the pipe
        if "/" in t:
            cand = self.root / (t if Path(t).suffix else t + ".md")
            return [cand] if cand.exists() else []
        return self.by_name.get(t, []) or self.by_name.get(Path(t).stem if t.endswith(".md") else t, [])

    def ambiguous(self, paths: list[Path]) -> bool:
        """Bare name hitting several files. Non-books raw/ shadows of a wiki page are not ambiguous
        (bare name resolves to the wiki page by convention, see .claude/rules/wiki-format.md)."""
        if len(paths) <= 1:
            return False
        rels = [self.rel(p) for p in paths]
        if any(r.startswith("books/") for r in rels):
            return True
        if any("/wiki/" in r for r in rels):
            rels = [r for r in rels if "/raw/" not in r]
        return len(rels) > 1
ambiguous 把 vault 的寫作規則翻成程式:一般域的 raw 與 wiki 同名時,裸名 [[概念]] 依慣例指 wiki 頁,不算歧義;books 例外,因為書的沉澱檔 books/raw/{書名} 和心得頁 books/wiki/{書名} 都是有效的連結目標,裸名分不出來。
W5 排除閱讀登記簿:
    # W5 raw orphans (by last commit, not mtime)
    wiki_stems = {p.stem for p in v.wiki_pages()}
    for p in v.raw_files(None if not domain or domain == "hubs" else domain) if domain != "hubs" else []:
        if p in linked or p.stem in wiki_stems or v.rel(p).startswith("books/"):
            continue  # books/raw is the reading registry: unreviewed books are not orphans
        t = commit_t.get(v.rel(p))
        if t is None or now - t > orphan_days * 86400:
            age = "untracked" if t is None else f"{int((now - t) // 86400)}d"
            out.append(finding("W5", v.rel(p), f"raw not referenced by any page (last commit {age})"))
books/raw/ 是一書一檔的登記簿,登記了但還沒寫心得的書,本來就沒有頁面指向它。
驗證改成重跑 lint
/vault-maintain 的 Phase 3 從「派 agent 覆核整批」改成:
### Phase 3 — 套用 + 驗證(僅 `--apply`)

1. 主 agent 逐筆套用 AUTO(單寫入點)。
2. 重跑 `lint.py`:修過的 finding 要消失、不能多出新的。沒消失或多出來的回滾該筆、轉 HUMAN。
3. 刪除類(I5、I6、刪衝突副本)另派 1 個 sonnet reviewer,限定覆核「被刪的東西是否確實可復原或確實多餘」
reviewer 的提示也從「預設懷疑、傾向 fail」改成限定範圍的問題:刪的 triage 檔是否在保留窗外、刪的分支 commit 是否還能從 main、GitHub 上的變更紀錄或 archive tag 找回來。doctor 的研究筆記裡有一條官方建議跟這個方向一致:要 reviewer「找缺口」會過度回報,應該限定在正確性和明訂的需求。
踩到的坑
數字三次都不對
lint.py 寫完第一次跑全 vault,結果是:
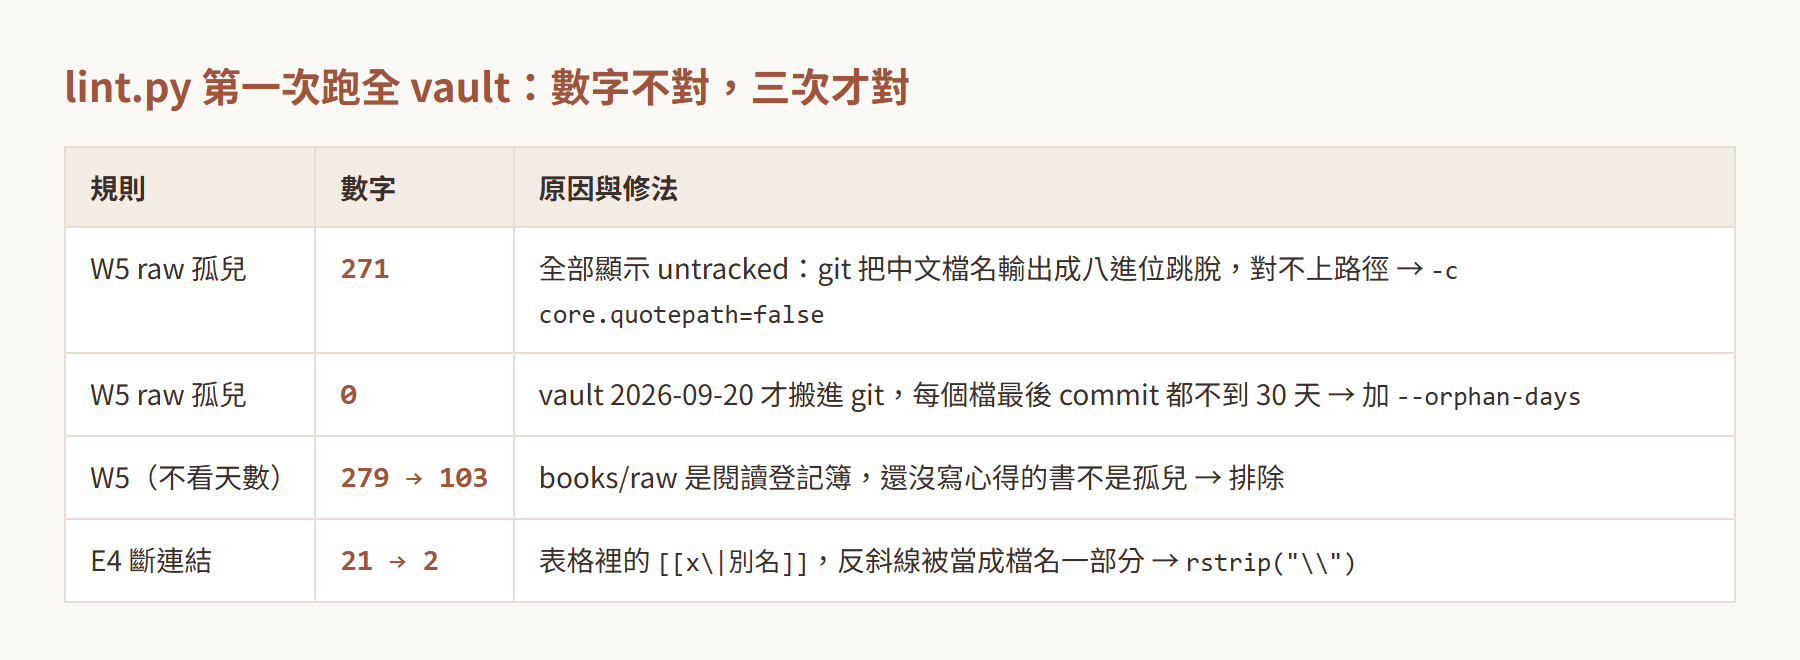
vault: E2 4 / E4 21 / E6 14 / I3 1 / W1 2 / W3 16 / W4 56 / W5 271
W5 的 271 條每一條都寫著 last commit untracked,連幾天前才改過的檔也是。原因是 git 預設會把非 ASCII 的路徑用引號包起來、轉成八進位跳脫輸出,vault 的檔名大多是中文,查表時一條都對不上。加上 -c core.quotepath=false 之後,W5 變成 0。
0 也不對。原因在資料本身:vault 是 2026-09-20 才從 iCloud 搬進 git 的,所有檔案的最後 commit 都不到 30 天。這不是 bug,規則在 10 月下旬之後才會開始有結果,所以加了 --orphan-days 參數,用 --orphan-days 0 看不考慮天數時有多少:279 條,其中 176 條是 books/raw/ 的書,就是上一段排除登記簿的由來,排除後是 103 條。
E4「斷連結」的 21 條,大部分集中在同一頁,而且長得一樣:
E4 coffee/wiki/sensory-evaluation.md:429 broken link [[風味的感知有很大一部分來自嗅覺80%\]]
結尾多一個反斜線。這是 Markdown 表格裡的寫法:連結的別名分隔符 | 跟表格欄位分隔符撞了,所以寫成 [[目標\|別名]]。正規式在 | 停下,反斜線就留在檔名裡。rstrip("\\") 之後剩 2 條,都是同一個真的不存在的頁面。
刪掉的 skill,另一邊還在用
修正輪還在進行時,main 那邊同時有別的 session 在改 vault:book-review 加了口吻改寫和「他人視角」步驟,還新增了 /study 和 /cdn-image 兩個 skill。併回 main 時有 4 個檔衝突,都是兩邊各自改了同一段,兩邊的內容都留下即可。
沒有衝突、但壞掉的是另一處:新的 /study 收尾時會提議「從日誌整理一段 Threads 短文草稿,提議 /threads-cards」,而 threads-cards 已經在這邊刪掉了。git 不會把這個當成衝突,是併完用 grep 找所有被刪 skill 的名字才找到,改成直接把草稿交給我貼。
小結
報告列的 7 條 🔴 和 17 條 🟡 都處理完了:🔴4–6 先修好、後來隨 skill 一起移除,一條 🟡 因為 skill 刪掉而不適用,其餘修完。報告檔裡每條前面都標了 ✅ 已修 或理由。設定目錄 .claude/ 底下改了 42 個檔,+536/−1759,刪掉的大部分是那 6 個 skill。
/vault-maintain 的掃描從「每次現寫」變成一支入庫的腳本,修完重跑它就是驗證,額外的 agent 只留給刪東西的時候。第一次跑全 vault 的三個數字錯誤,都是規則表直譯成程式時沒寫出來的前提:mtime 能代表閒置、檔名是 ASCII、| 一定是別名分隔符。這些前提現在都寫進了 lint.py。