今天要解的問題
Day10 結尾我留了四句話:
先立三層加一個域加一份 CLAUDE.md,再裝 inbox-triage,跑一陣子之後把常一起用的指令收成管線,等到某類錯誤反覆發生再把那一條變成 hook。
那四句是結論。今天要做的是把它展開成可以照著做的版本,順便交代每一步我沒那樣做的時候付了什麼代價。
有兩個數字先擺出來,它們是這篇的骨架。
第一,CLAUDE.md 現在 201 行、8 個段落。逐段數完之後最反直覺的一筆是:大家以為是主體的「行為準則」只有 14 行,佔 7%;「東西放在哪、長什麼樣」那三段加起來 105 行,佔一半以上。
第二,skill 從 2026-04-15 建庫那天的 9 個開始,現在 15 個。但這不是「淨增 6 個」那麼平順——中間有 10 個名字已經不在了,有的被併掉,有的整批搬出 vault 變成獨立工具。
這篇不是「我的 vault 有多好」,是「照這個順序蓋,你可以少繞我繞過的路」。
想法與取捨
第 0 步:一份 CLAUDE.md 加一個域
先給實際盤點。這是 201 行怎麼分配的:
| 段落 | 行數 | 佔比 |
|---|---|---|
| 路由(內容該放哪) | 39 | 19% |
| Domain 結構 | 34 | 17% |
| 寫作格式 | 32 | 16% |
| Skills 指令表 | 28 | 14% |
| 環境注意(git 跨平台) | 27 | 13% |
| 流程(資料流向) | 14 | 7% |
| 行為準則 | 14 | 7% |
| 圖片放置 | 9 | 4% |
第一次數出這張表的時候我有點意外。我以為這份檔案的重心是「教 LLM 怎麼做事」,結果它九成在回答「東西放哪、長什麼樣」。行為準則那 14 行短到不像一個段落。
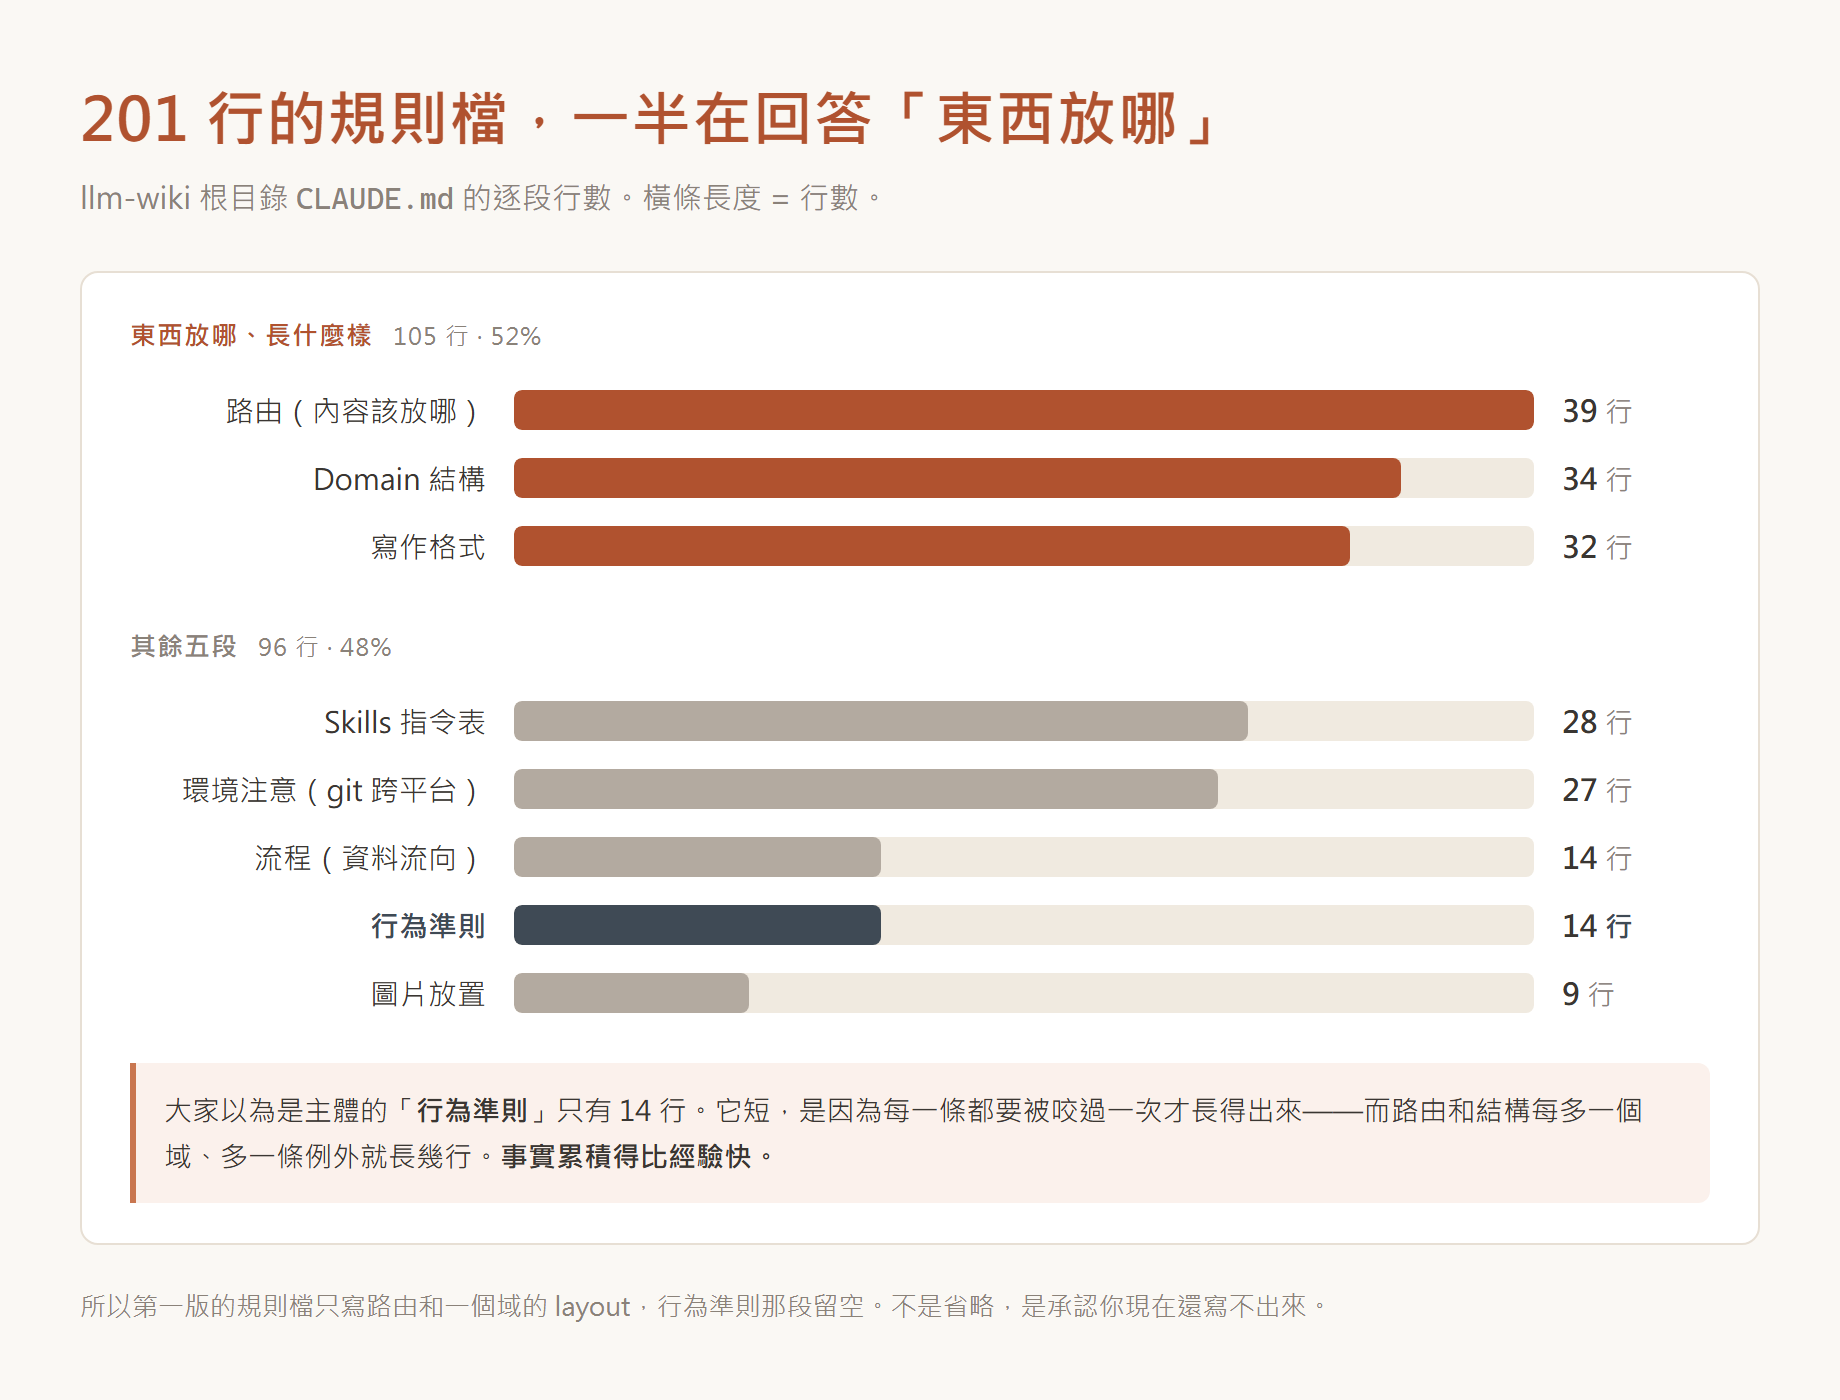
想通之後覺得這是對的。行為準則之所以短,是因為它每一條都是被咬過之後才長出來的,而咬過的次數有限;路由和結構之所以長,是因為每多一個域、每多一條例外,它就要多幾行。前者靠經驗累積,後者靠事實累積,事實累積得比經驗快。
所以給要開始的人的建議是:第一版的 CLAUDE.md 只寫路由和一個域的 layout,行為準則那段留空。
不是省略,是承認你現在還寫不出來。你還沒看過 LLM 在你的資料上會怎麼犯錯,現在寫的行為準則只會是從別人文章抄來的通則,而通則擋不住你自己的問題。
拿我自己的一條當例子。CLAUDE.md 現在有這麼一行:
books域只放書頁(一書一頁);ingest 提取的概念頁一律路由至主題域
這條看起來像是一開始就想好的設計。它不是。2026-07-05 我盤 books/wiki/ 的時候,95 個檔裡挖出 52 張根本不是書頁的概念頁——它們是讀書時提煉出來的獨立概念,被順手寫在 books 底下了。
收拾的帳是這樣的:52 張搬去主題域(ideas 40、engineer 6、art 4、coffee 2),修 52 張卡的內部連結,另外修 3 篇 ideas 頁裡 23 條指向舊路徑的連結,回填 22 本書頁的「## 概念頁」區塊,同一輪還一起修了 256 條全路徑連結。
那條規則是在這整包做完之後才補進 CLAUDE.md 的。它不是設計,是判決書。
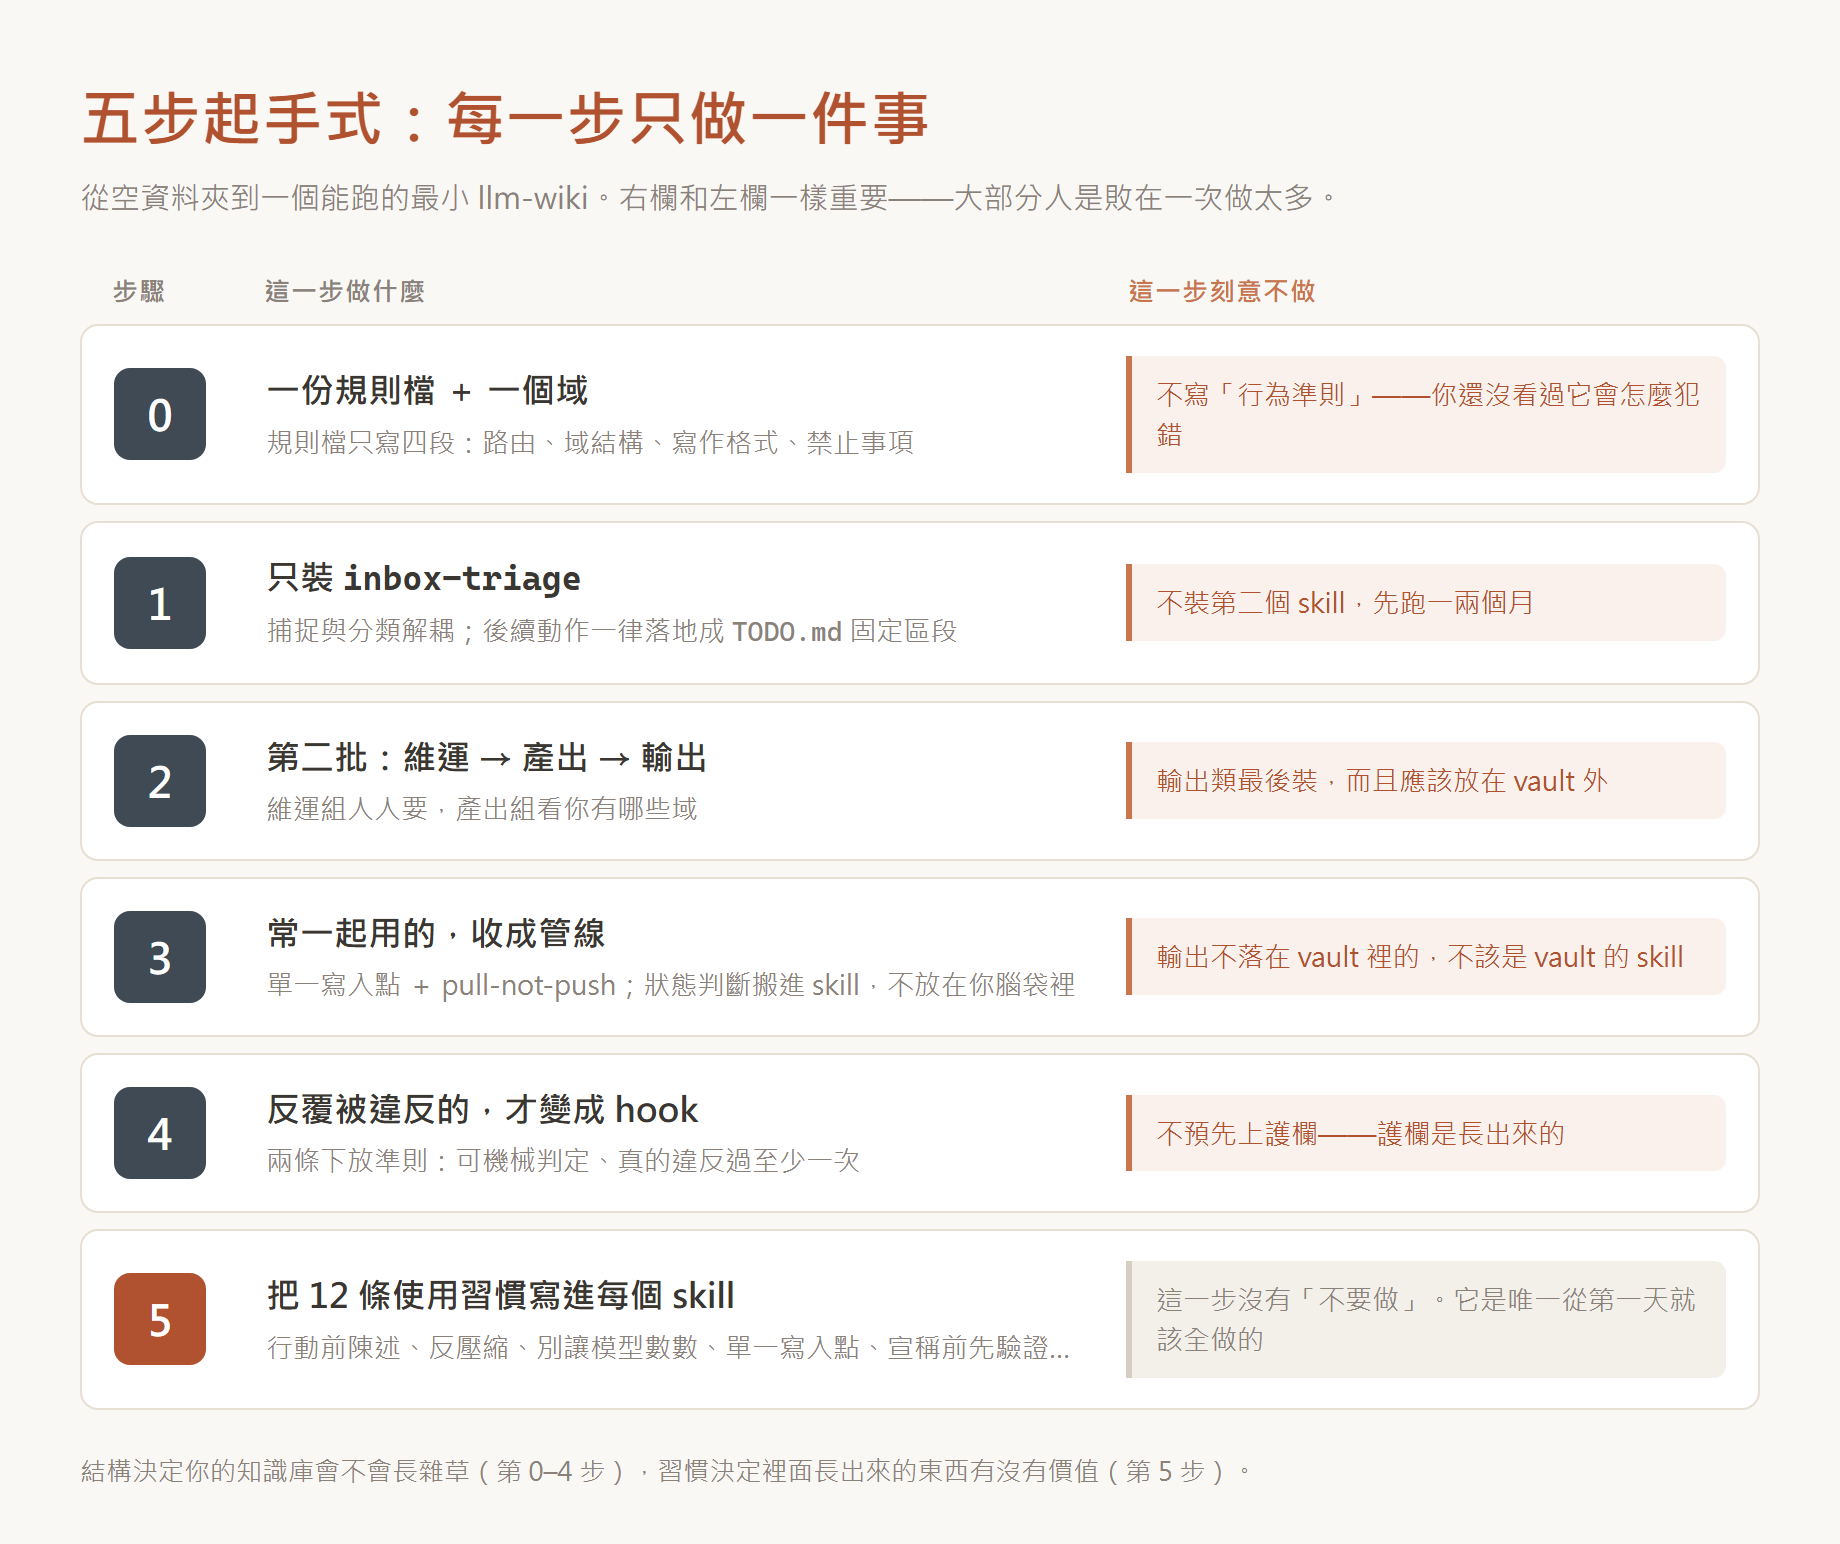
第 1 步:只裝 inbox-triage
第二步裝什麼,我的答案很肯定:先只裝一個 /inbox-triage,其他都先不要。
理由是它解的是唯一一個會讓整套系統死掉的問題——捕捉和分類要解耦。你在捷運上想到一件事,當下要你決定它屬於哪個域、該叫什麼檔名,你就不會記了。所以入口一律是 Inbox/ 加時間戳檔名,分類是後面的事。
但這個 skill 有一個細節,是我覺得別人最容易漏掉的:triage 的產出必須落地成檔案,不能只在對話裡講一句。
早期版本的 triage 分類完會說「這幾個檔之後可以跑 enrich」,然後就沒有然後了。管線的斷點全部落在人腦記憶上——分類完接下來該對哪幾個檔做什麼?沒人記得,那些檔就永遠停在 raw/。
現在 SKILL.md 裡這條是寫死的:
核心規則:需要 skill 協助的 note 一律入 `TODO.md`。任何決定欄指向需要後續
skill(enrich / note-explore / wiki-build / 建造 / 擴充 …)的項目,不可只在
對話提一句——必須在根目錄 TODO.md 追加一條 TODO
而且指定了區段:一律追加到 ## FROM INBOX-TRIAGE,不分散到 Articles / Coding / Thinking。統一收納,才找得到。
一句話版本:管線的接力棒要有實體。
還有一條同樣重要的:triage 不逐條問你。它把所有判斷寫成一份決策檔(Inbox/_reviews/triage-review-*.md),你一次看完一次改完,而不是被問 20 次「這個要放哪」。這條在後面的習慣清單裡叫「決策檔優於對話」。
第 2 步:第二批裝什麼
跑一兩個月之後才輪到擴充。15 個 skill 我會分成三組,建議的安裝順序就是這個順序:
維運組(任何人都該有)
| skill | 做什麼 |
|---|---|
/inbox-triage | 分類 Inbox,路由到 raw / logs,後續動作寫進 TODO.md |
/wiki-build | 整合多份 raw 成 wiki 頁,反壓縮紀律 |
/wiki-query | 索引加速查詢,不掃全庫 |
/vault-maintain | 健康巡檢唯一入口,機械項腳本跑、語意項模型跑 |
/note-enrich | 對任何 note 做網頁搜尋補充,事實就近融入 |
產出組(看你有哪些域)
| skill | 做什麼 |
|---|---|
/book-review | 書籍管線一條龍,登記→心得→概念外提 |
/art-review | 觀展登記+藝評+概念外提,含污染防火牆 |
/note-explore | 靈魂拷問加發散探索 |
/finance-db-extract | 從財務 app 的 SQLite 匯出資產 |
輸出組(最後才裝)
| skill | 做什麼 |
|---|---|
/edit-article | 收斂文章草稿,減法先行 |
/subtitle-draft | 流程導向副標題 |
/threads-cards | 產 Threads carousel 圖卡 |
/medium-cover | 產 Medium 封面圖 |
/wiki-render | 渲染 Marp 投影片 |
/wiki-compile | 打包匯出單域 |
三組的順序不是隨便排的。維運組決定 vault 會不會長雜草,產出組決定你寫不寫得出東西,輸出組決定東西怎麼出去——而第三組是最容易在一開始就手癢先做、然後變成技術債的那一組。原因在下一步。
第 3 步:什麼時候把 skill 收成管線
判準兩條,Day10 提過,這裡展開。
單一寫入點:每個管線只有一個入口。讀完一本書就是 /book-review,它自己判斷現在該走哪一段。
正例就是它。/book-review 是 15 個裡最長的一個,285 行,而開頭第一段不是流程,是進場判斷:
## Mode gate(進場判斷,先於一切)

讀 `books/raw/{書名}.md` 與 `books/wiki/{書名}.md` 的存在狀態,決定走哪條路:

| 狀態 | Mode |
|------|------|
| `books/raw/{書名}.md` 不存在 | **A 登記** |
| raw 存在、`books/wiki/{書名}.md` 尚無心得 | **B 心得**(完成後自動接 C) |
| 心得已存在 | **C ingest / 心得補強**(問使用者要哪個) |

判斷後先陳述:「《{書名}》目前狀態是 {…},我會走 Mode {X}。」再開始。
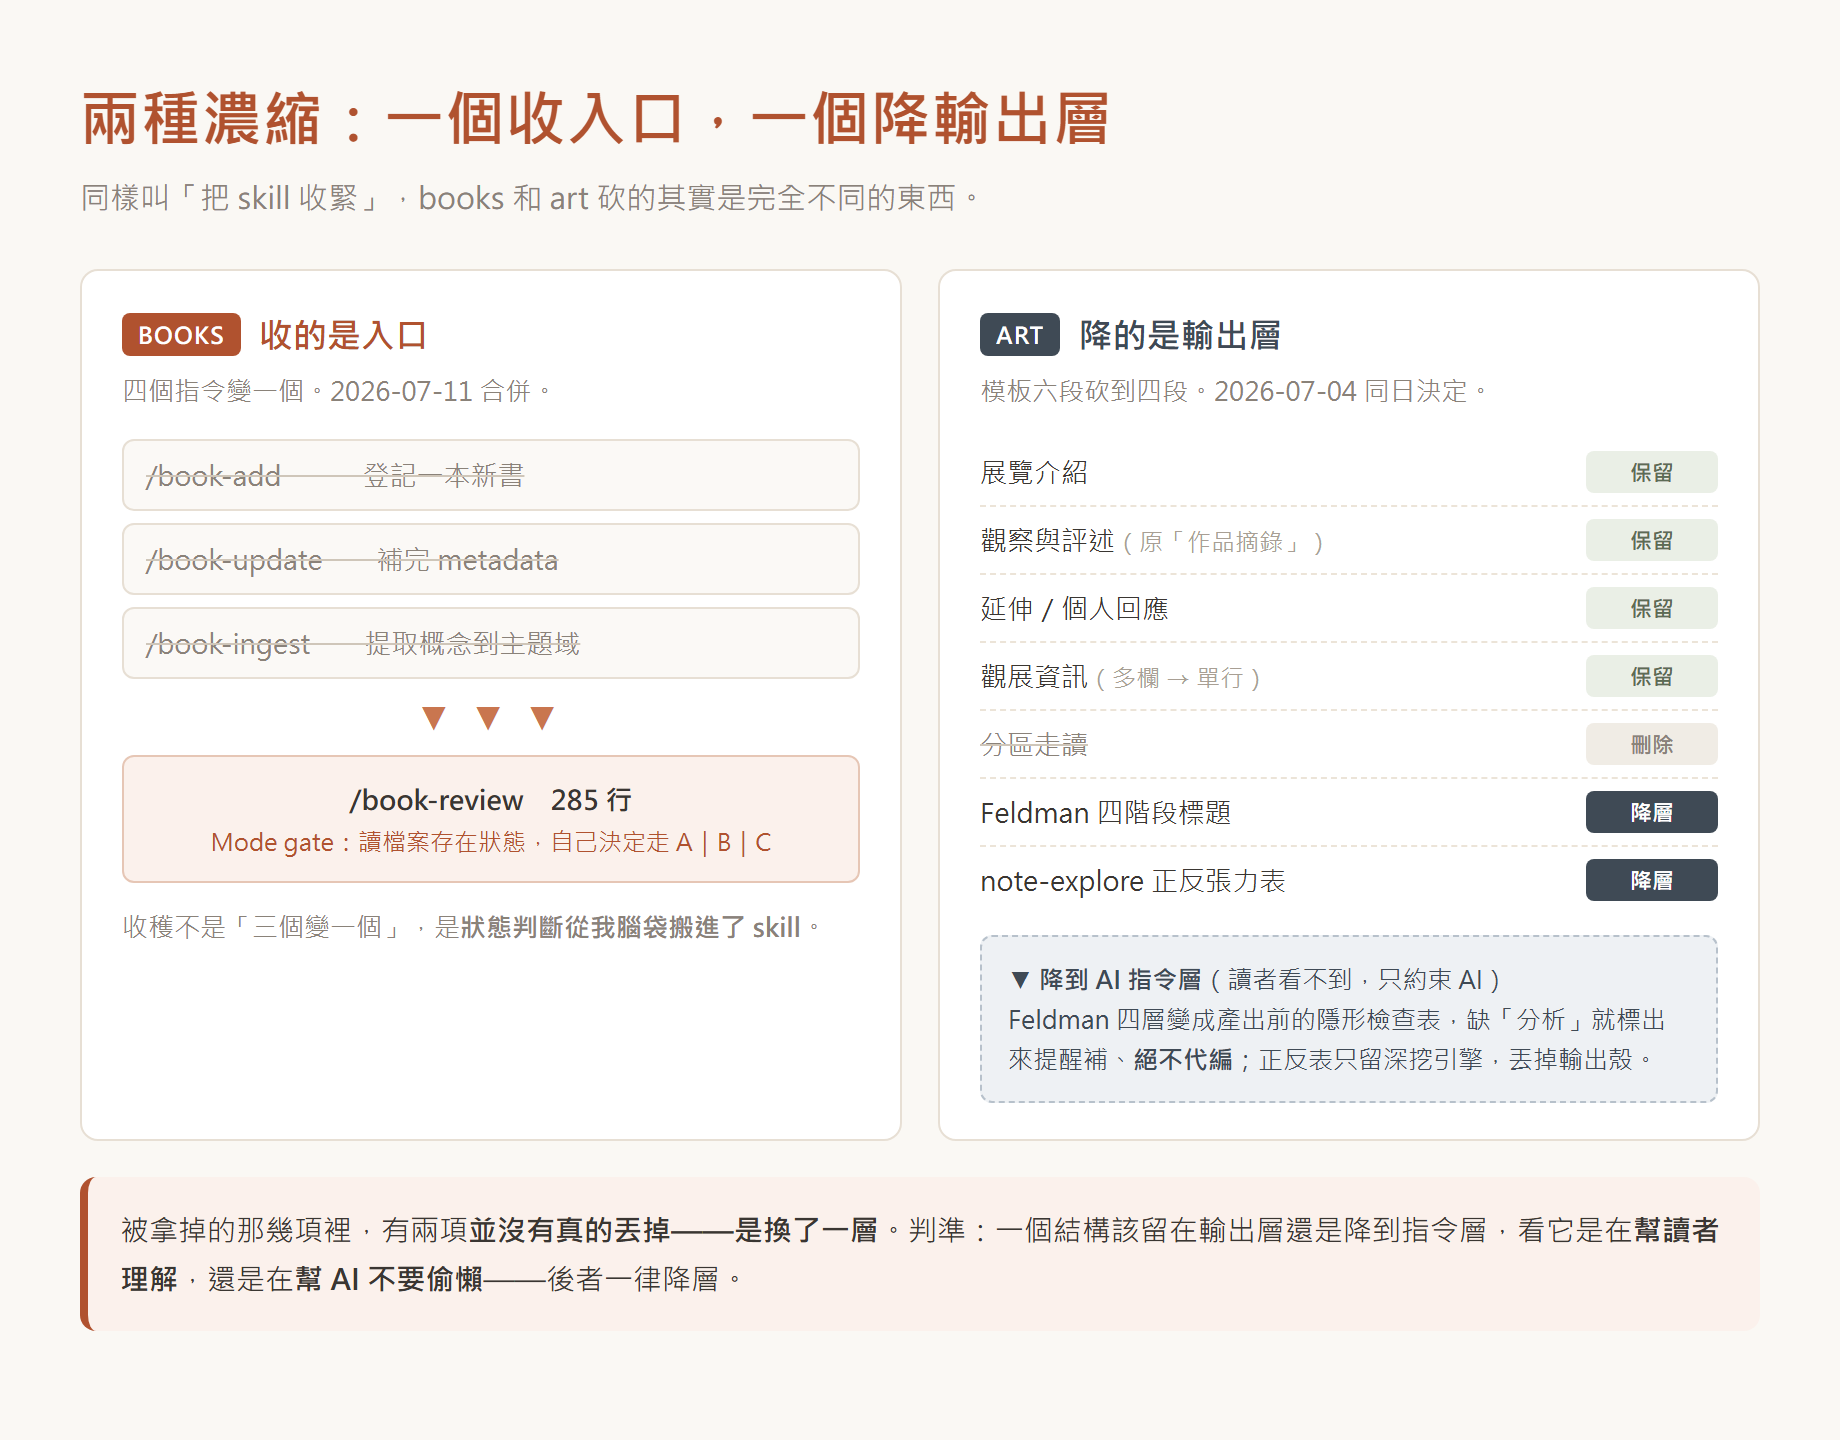
這一段取代的是三個舊指令:book-add(登記)、book-update(補完)、book-ingest(概念外提)。它們在 2026-07-11 全部併進來。
關鍵不是「三個變一個」,是狀態判斷從我腦袋搬進了 skill。以前我得記得這本書走到哪一步了;現在它自己讀檔案存在狀態就知道。
pull-not-push:skill 收尾時主動提議下一步,而不是散成一堆要自己記得串接的小指令。/book-review 的 B6 寫死「自動接 Mode C」,寫完心得直接進概念外提,不問我要不要。
那什麼叫「看起來像管線、其實只是串接」?
反例我有一組現成的:舊的四個發布指令 /site-promote、/site-demote、/site-status、/site-publish。
它們共用同一套 lib、名字同前綴、文件裡也畫了流程圖,看起來很像一條管線。但實際用起來永遠是:先跑 status 看目前狀態,想一下,再決定跑 promote 還是 publish。狀態判斷還是在我腦袋裡——它只是四個共用程式碼的獨立指令,不是管線。
不過它真正的問題比這個更根本。2026-07-21 我把這四個整批刪掉,13 個檔含 lib 程式與測試,發布功能整包搬出 vault,變成一個獨立的工具 vault-forge。
搬出去的理由是邊界,不是數量。這四個指令的輸入是 vault,輸出是 Hugo 的 content 目錄——輸出不落在 vault 裡。它們跟著 vault 走的唯一理由是「當初順手寫在那」。一旦發布端的格式要改(frontmatter 扁平化、封面欄位調整),我就得改 vault 裡的程式碼,而 vault 應該是內容,不是應用程式。
所以第三條判準,是我事後才補上的:輸出不落在 vault 裡的東西,不該是 vault 的 skill。
這也是為什麼前面建議輸出組最後才裝。它們是最容易寫、最有成就感、也最容易把邊界搞糊的一組。
兩種濃縮:books 收入口,art 降輸出層
前面 books 那條是把四個指令收成一個,那是入口的濃縮。art 域走的是另一條路,值得單獨講,因為它砍的是輸出。
/art-review 的前身也規劃過兩個 skill——對照 books 做一個 art-visit(登記看過哪場展)加一個 art-review(寫藝評)。2026-07-04 併成一個,理由很直接:登記那段邏輯薄到不值得獨立成 skill,而且併了之後「逛完先登記、過幾天再回來寫評論」變成同一個入口,重跑時自動跳過登記。
這部分跟 books 一樣。真正不一樣的是同一天砍掉的模板。
| 砍掉的 | 為什麼 |
|---|---|
## 分區走讀 | 我的輸入是逛展時的破碎想法,對不上展場分區 |
## 作品摘錄(每件一段) | 同一個理由——我大部分不會逐件點名作品 |
| Feldman 四階段當輸出標題 | 學院派、嚴謹,但冷,而且我本來就不是在寫論文 |
| note-explore 的正反方張力表 | 我明講過不要「結果呈現是什麼正反方」 |
| 觀展資訊的多欄表格 | 降成單行 2026/06 高美館〈典藏庫房的竊竊私語〉 |
模板最後剩四段:展覽介紹 → 觀察與評述 → 延伸/個人回應 → 觀展資訊。
但這張表有個地方會誤導人。砍掉的五項裡有兩項並沒有真的被丟掉,是換了一層。
Feldman 四階段(描述 / 分析 / 詮釋 / 判斷)從輸出標題降成了 AI 的隱形檢查表。它現在不出現在文章裡,但 skill 每處理完一群碎片就默過一次四層,缺的標出來提醒我補——尤其是「分析」,也就是形式怎麼運作,那是業餘寫觀後感最容易漏的一層。而且明文規定:缺了就留白,絕不代編。
note-explore 的深挖也一樣。砍掉的是它的輸出殼(正向反向的紅綠燈、正反張力表格),留下的是它的引擎(銳利追問、跨域連結、外部 reference),然後寫成流動的散文。當時的決策文件裡那句比我現在講的準:取兩者的引擎,丟掉輸出殼。
所以濃縮有兩種形狀:
- books 收的是入口 — 四個指令變一個,狀態判斷從我腦袋搬進 skill
- art 降的是輸出層 — 六段模板砍到四段,而砍掉的結構有一半是降級成只給 AI 看的檢查表
第二種比第一種難。第一種你只要判斷「這幾個動作是不是總是連在一起做」;第二種你得判斷「這個結構是專業,還是只是看起來專業」。
Feldman 四階段放在標題上,任何人都會覺得這篇藝評很專業。但我的輸入從來就不是逐件作品的冷靜觀察,是一堆逛完展之後還黏在腦子裡的碎片。輸出格式跟輸入形狀對不上的時候,那個專業感是假的——它只會逼 AI 去填那些我根本沒有的內容,而 AI 一定填得出來,填得還很好看。
判準可以收成一句:一個結構該留在輸出層還是降到指令層,看它是在幫讀者理解,還是在幫 AI 不要偷懶。 後者一律降層。
第 4 步:哪幾條該下放成 hook
寫在 CLAUDE.md 和 skill 裡的是軟約束,靠 LLM 自律。覆蓋面很廣(所有動作都吃得到),強制力是零,而且失敗是隨機的——同一條規則今天守了明天沒守。
hook 反過來:覆蓋面窄(只擋特定工具呼叫),但強制力是物理的。
現在 PreToolUse 擋四件事:根目錄寫一次性腳本、寫進依賴夾、產生衝突副本檔名、wiki 頁缺 summary / tags / date。
下放的準則我只有兩條真的在用:
一、可機械判定。 「檔名符不符合 pattern」可以;「這頁路由得合不合理」不行。這條跟 Day10 那個坑是同一件事——讓模型去數數,它會把 43 本書數成 41 本,而且數字看起來合理到你不會想驗。可機械判定的一律寫成唯讀腳本,模型只負責語意層。
二、真的違反過至少一次。 這四條每一條背後都有一次實際發生的違規,沒有一條是「想得到所以先擋著」。
第二條比第一條重要。一開始就把想得到的規則全部寫成 hook,你會得到一堆從來沒觸發過的檢查,外加一個沒人敢改的 dispatcher。護欄是長出來的,不是設計出來的。
第 5 步:把使用習慣寫進 skill
這是最重要的一步,也是最容易被跳過的。
前面四步講的都是結構:檔案放哪、指令怎麼切、哪條要擋。但結構決定不了品質。同樣一個 /wiki-build,寫法不同,可以產出一份忠實的整合頁,也可以產出一份把五份 raw 壓成三段空話的摘要。
差別在於有沒有把使用習慣明文寫進 skill 定義。這 12 條是我現在會抄進每一個新 skill 的:
- 反壓縮 / 反代編 — 整合是擴張加去重,不是壓縮;藝評絕不代編、note-explore 問完就停不自答
- 機械 vs 語意 + 模型分層 — 可數的交給腳本,語意交給中階模型,最輕的模型只搬運
- fan-out 唯讀 + 單一寫入點 — subagent 並行只讀不寫,只有主 agent 寫入
- verify-before-claim — 每個自動修復派一個預設懷疑的 subagent 去驗,沒過就 rollback
- 行動前陳述 — 開跑前先說出理解與計劃,讓你在副作用發生前糾正
- 決策檔優於對話 — 強制匯出決策檔,禁止逐條對話審問
- dedup 閘門 — 建新頁前先查重,預設併入而非新建
- backlink-before-move — 先改連結再移檔,沒有斷鏈空窗
- mode / type gate — 進入前先判狀態、先判型別,用狀態決定路徑
- 污染防火牆 — 外部材料只能磨利你的問題,不能假扮成你的判斷
- 自動收斂 — 產出頁寫完直接跑去 AI 味收斂,不先問
- 跨域連結 pass — 收尾時掃其他域 index,列候選附理由,確認才寫入
挑五條展開。
別讓模型數數(第 2 條)。 這是分層的起點。現在的分工是硬規則:欄位缺漏、連結格式、index 同步、壞連結、孤兒 raw、計數,一律唯讀腳本,輸出結構化 JSON,主 agent 直接信任。LLM 只判斷兩頁講的是不是同一個概念、這叢 tag 是不是一個真的主題。這條不只是省 token,是把「會錯得很安靜」的那一類任務整個移出模型的職責範圍。
fan-out 唯讀加單一寫入點(第 3 條)。 全 vault 巡檢時每個域派一個 subagent 並行掃,但它們全部只讀。所有寫入回到主 agent,而主 agent 受 hook 保護。這讓並行變安全——並行最怕的是兩個 agent 同時改同一個檔,只要寫入點只有一個,這個問題就不存在。
verify-before-claim(第 4 條)。 /vault-maintain --apply 每修一項,就派一個 subagent 去驗,而且這個 subagent 的 prompt 明文要求它「預設懷疑、傾向判失敗、真的讀檔」。沒過就 rollback。這條是對「模型傾向宣稱成功」的直接對抗——不是加一層保險,是承認第一層的自我回報不可信。
決策檔優於對話(第 6 條)。 前面 triage 那段講過。它改變的是注意力的形狀:從「一直被打斷回答」變成「一次填完」。任何要問使用者超過三次的 skill,都該考慮改成決策檔。
污染防火牆(第 10 條)。 這條是 /art-review 專屬的,但它的思路可以移植。比喻是:碎片是礦石,外部資料是磨刀石,磨出來的必須還是你的礦。三道分離機制是實體化的:
### 三道分離機制(provenance 已實體化)
- 來源標記=實體規則:`觀察與評述` 只准放使用者倒雜訊說過、或對追問明確
  回覆確認的內容。任何 AI 由外部/Feldman 推出、使用者未點頭的讀法,一律強制
  寫進 `延伸/個人回應` 並加標記((策展論述稱…)/(AI 提問,待你確認))。
- 確認閘門:外部引出的讀法先當問題丟給使用者;點頭才能從「延伸暫存」升進
  「觀察與評述」。
- 段落隔離:展覽介紹=外部/事實(標 source)|觀察與評述=使用者親見+確認過
  |延伸=混合但逐句標示誰說的。
關鍵在「實體化」三個字。不是寫一句「請不要把官方論述當成使用者的觀點」——那是願望。而是規定 AI 推出來的讀法只能寫進另一個段落、而且必須帶標記,然後只有經過確認閘門才能搬家。來源純度變成一個看得見的結構,不是一個要 LLM 記得的態度。
回到這一步的論點:skill 的名字會換,數量會變。從 9 個到 15 個、中間 10 個名字退場,全部發生在名字那一層。這 12 條沒有一條被換掉過。
實作
CLAUDE.md 的段落骨架
貼標題層級就好,實際內容各自長得不一樣,你的域跟我的域不會一樣:
# CLAUDE.md — Vault Schema

## Skills(指令清單)        ← 表格,skill 資料夾是唯一 source of truth
## 路由(內容該放哪)          ← Inbox 分類 / 概念路由 / 禁止事項
## 寫作格式                  ← frontmatter 必填欄位 / index 條目 / log 格式
## 圖片放置
## 流程(資料流向)            ← 一張 ASCII 圖,從 Inbox 到 wiki
## Domain 結構               ← records 型 vs logs 型,二擇一
## 行為準則                  ← 查重閘門 / 管線推進 / 跨域連結 pass / 查詢規則
## 環境注意(git 跨平台同步)
有一條維持它不腐爛的規則值得單獨提:skill 表以 .claude/skills/ 為唯一 source of truth。 CLAUDE.md 裡那張表只是給人看的摘要,真實定義在資料夾裡。這樣退掉一個 skill 的時候,該改哪裡是明確的,不會出現文件說有、實際沒有的狀態。
15 個 skill 的規模
| skill | 行數 |
|---|---|
/book-review(最長) | 285 |
/medium-cover | 199 |
/subtitle-draft | 195 |
/threads-cards | 192 |
/note-explore | 168 |
/art-review | 164 |
/note-enrich | 154 |
/inbox-triage | 144 |
/vault-maintain | 142 |
/finance-db-extract | 119 |
/wiki-build | 71 |
/wiki-render | 55 |
/edit-article | 52 |
/wiki-query | 51 |
/wiki-compile(最短) | 34 |
| 合計 | 2025 |
這張表的分布本身就是資訊。長的那幾個(book-review、art-review、note-explore)全部是「要跟人對話、要反覆確認」的 skill——篇幅都花在 gate、在確認閘門、在「不准代編」的界線上。短的那幾個(wiki-compile、wiki-query、edit-article)是純執行,輸入輸出清楚,不需要跟人來回。
換句話說:skill 的長度跟任務複雜度關係不大,跟「它要抵抗模型多少種過度產出的傾向」關係很大。
踩到的坑
一、AI 把兩件作品寫成同一件
/art-review 第一次真的跑,是 2026-07-04 寫〈共織宇宙〉那場展。
我丟進去的是一堆破碎印象,沒有標哪句是講哪件作品的。結果 AI 把「真實蛛網的宇宙感」和「〈算法.韻律〉的白色空間黑線」黏成了同一件作品,然後基於這個錯誤的合併寫出了一整段分析。
寫得還挺好的。問題是那件作品不存在。
這個錯誤特別難抓,因為它不是憑空捏造——兩件作品都真的在場,兩句印象也都真的是我說的,只是被接錯了。你讀那段分析的時候看不出接點在哪。
當天就補了閘門,現在 Step 2 長這樣:
2. 作品歸屬確認(先做,別跳):分群後,先跟使用者核對「每一群大致對應哪件
   作品/哪個區塊」,等使用者確認或更正,才進深挖。破碎想法很容易把不同作品
   的印象黏在一起(首跑實例:把「真實蛛網的宇宙感」和「〈算法.韻律〉的白色
   空間黑線」混成一件)——這一步是防混淆的閘門,不確定就直接問,不要自己
   假設哪句屬於哪件。
兩個細節是刻意的。一是「先做,別跳」寫在標題裡,因為這一步很像多餘的確認、很容易被跳過。二是首跑實例直接寫進 SKILL.md——不是寫在 changelog,是寫在規則旁邊。規則旁邊放一個真實案例,比多寫三句解釋有用。
更一般的教訓:把碎片重組成敘事的時候,重組的接縫是最容易出錯、也最難被發現的地方。 任何「從散的變成整的」的 skill,都該在合併之前插一道歸屬確認。
二、books/wiki 混裝了三個月才發現
第 0 步講過這個帳,這裡補為什麼三個月都沒發現。
因為沒有任何機制檢查「一個域裡的東西是不是都該在這裡」。
當時的巡檢查的是:欄位缺不缺、連結斷不斷、index 有沒有同步、有沒有孤兒 raw。這些全都是檔案層級的檢查——每一張放錯地方的概念卡,單看它自己都完全合格:frontmatter 齊全、連結沒斷、index 有條目。
錯的是分類,而分類的正確性無法從單一檔案判斷。要發現它,你得把整個 books/wiki/ 拉出來問一句「這 95 個檔是不是都是書頁」,而那時候沒有任何流程會問這句。
這跟 Day8 那個坑是同一個病:文件說可攜、程式碼寫死路徑,而沒有任何機制檢查「文件說的跟實際做的一不一致」。規則寫下來不等於規則生效,中間差一個驗證。
現在補上的是 /vault-maintain 的語意掃描——它會回頭問域層級的問題:同一個概念是不是被建了兩份、這叢 tag 是不是一個跨域主題、這頁路由得合不合理。這一層必須是模型做的,因為它要判斷的是「這頁講的是什麼」,腳本判斷不了。
代價是慢、要花 token、而且結果需要人複審。但它抓得到檔案層級永遠抓不到的那一類錯誤。
機械檢查和語意檢查不是深淺的差別,是看的維度不同。 只做機械檢查,你的 vault 可以每一項都合格,同時整個分類是壞的。
Routines:我實際怎麼用它
講完該怎麼蓋,補一段該怎麼用。這段我本來不打算寫,因為數字不好看。
翻 log/ 算出來的實際節奏是這樣的——半年 199 筆操作,但只落在 42 個活躍天:
| 月份 | 操作筆數 | 活躍天數 |
|---|---|---|
| 2026-04 | 43 | 9 |
| 2026-05 | 76 | 12 |
| 2026-06 | 8 | 3 |
| 2026-07 | 47 | 10 |
| 2026-08 | 3 | 3 |
| 2026-09 | 22 | 5 |
五月衝到 12 天 76 筆,六月和八月各只有 3 天。這不是「每天寫筆記」的作息,是爆發式的。
但我決定照實寫,因為這個數字恰好證明了一件事:它斷了兩次一整個月,沒有壞掉。
斷檔期間我還是有在丟東西進 Inbox,只是沒處理。八月回來的時候 Inbox 很長,但 books/、engineer/ 那些既有的結構完全沒受影響——因為 Inbox 把捕捉和處理解耦了,斷檔只會讓佇列變長,不會讓結構腐爛。
這才是 Inbox 當唯一入口真正的回報。它表面上解的是「捕捉時不用想分類」,實際上解的是抗斷。任何需要你天天維護才不會崩的個人系統,遲早會崩,因為人一定會斷。
具體的 routine 分兩端,形狀完全不同。
捕捉端有四個入口,全部是隨時的:
- 手機隨手丟(Obsidian mobile 或快捷指令),想到就寫,時間戳檔名,不分類
- 讀完一本書、看完一場展,一次性把當時的碎片全倒進去
- 電腦上看到好文章就存進去
- 跟別的 AI 對話完,把有價值的結果倒進來
處理端只有三個觸發,全部不是排程的:
- Inbox 堆到看不下去,跑
/inbox-triage(閾值觸發,這是最常見的) - 週末固定一段時間坐下來清
- 要寫文章之前,回頭把相關的 raw 收成 wiki
唯一真正排程化的只有一件事:/vault-maintain 設成每週跑一次的 routine。 機械項由腳本掃,語意項派 subagent 並行掃,我只看報告和決定要不要 --apply。這是整套系統裡唯一不依賴我心情的環節,也是它在我斷檔一整個月之後還能收拾得回來的原因。
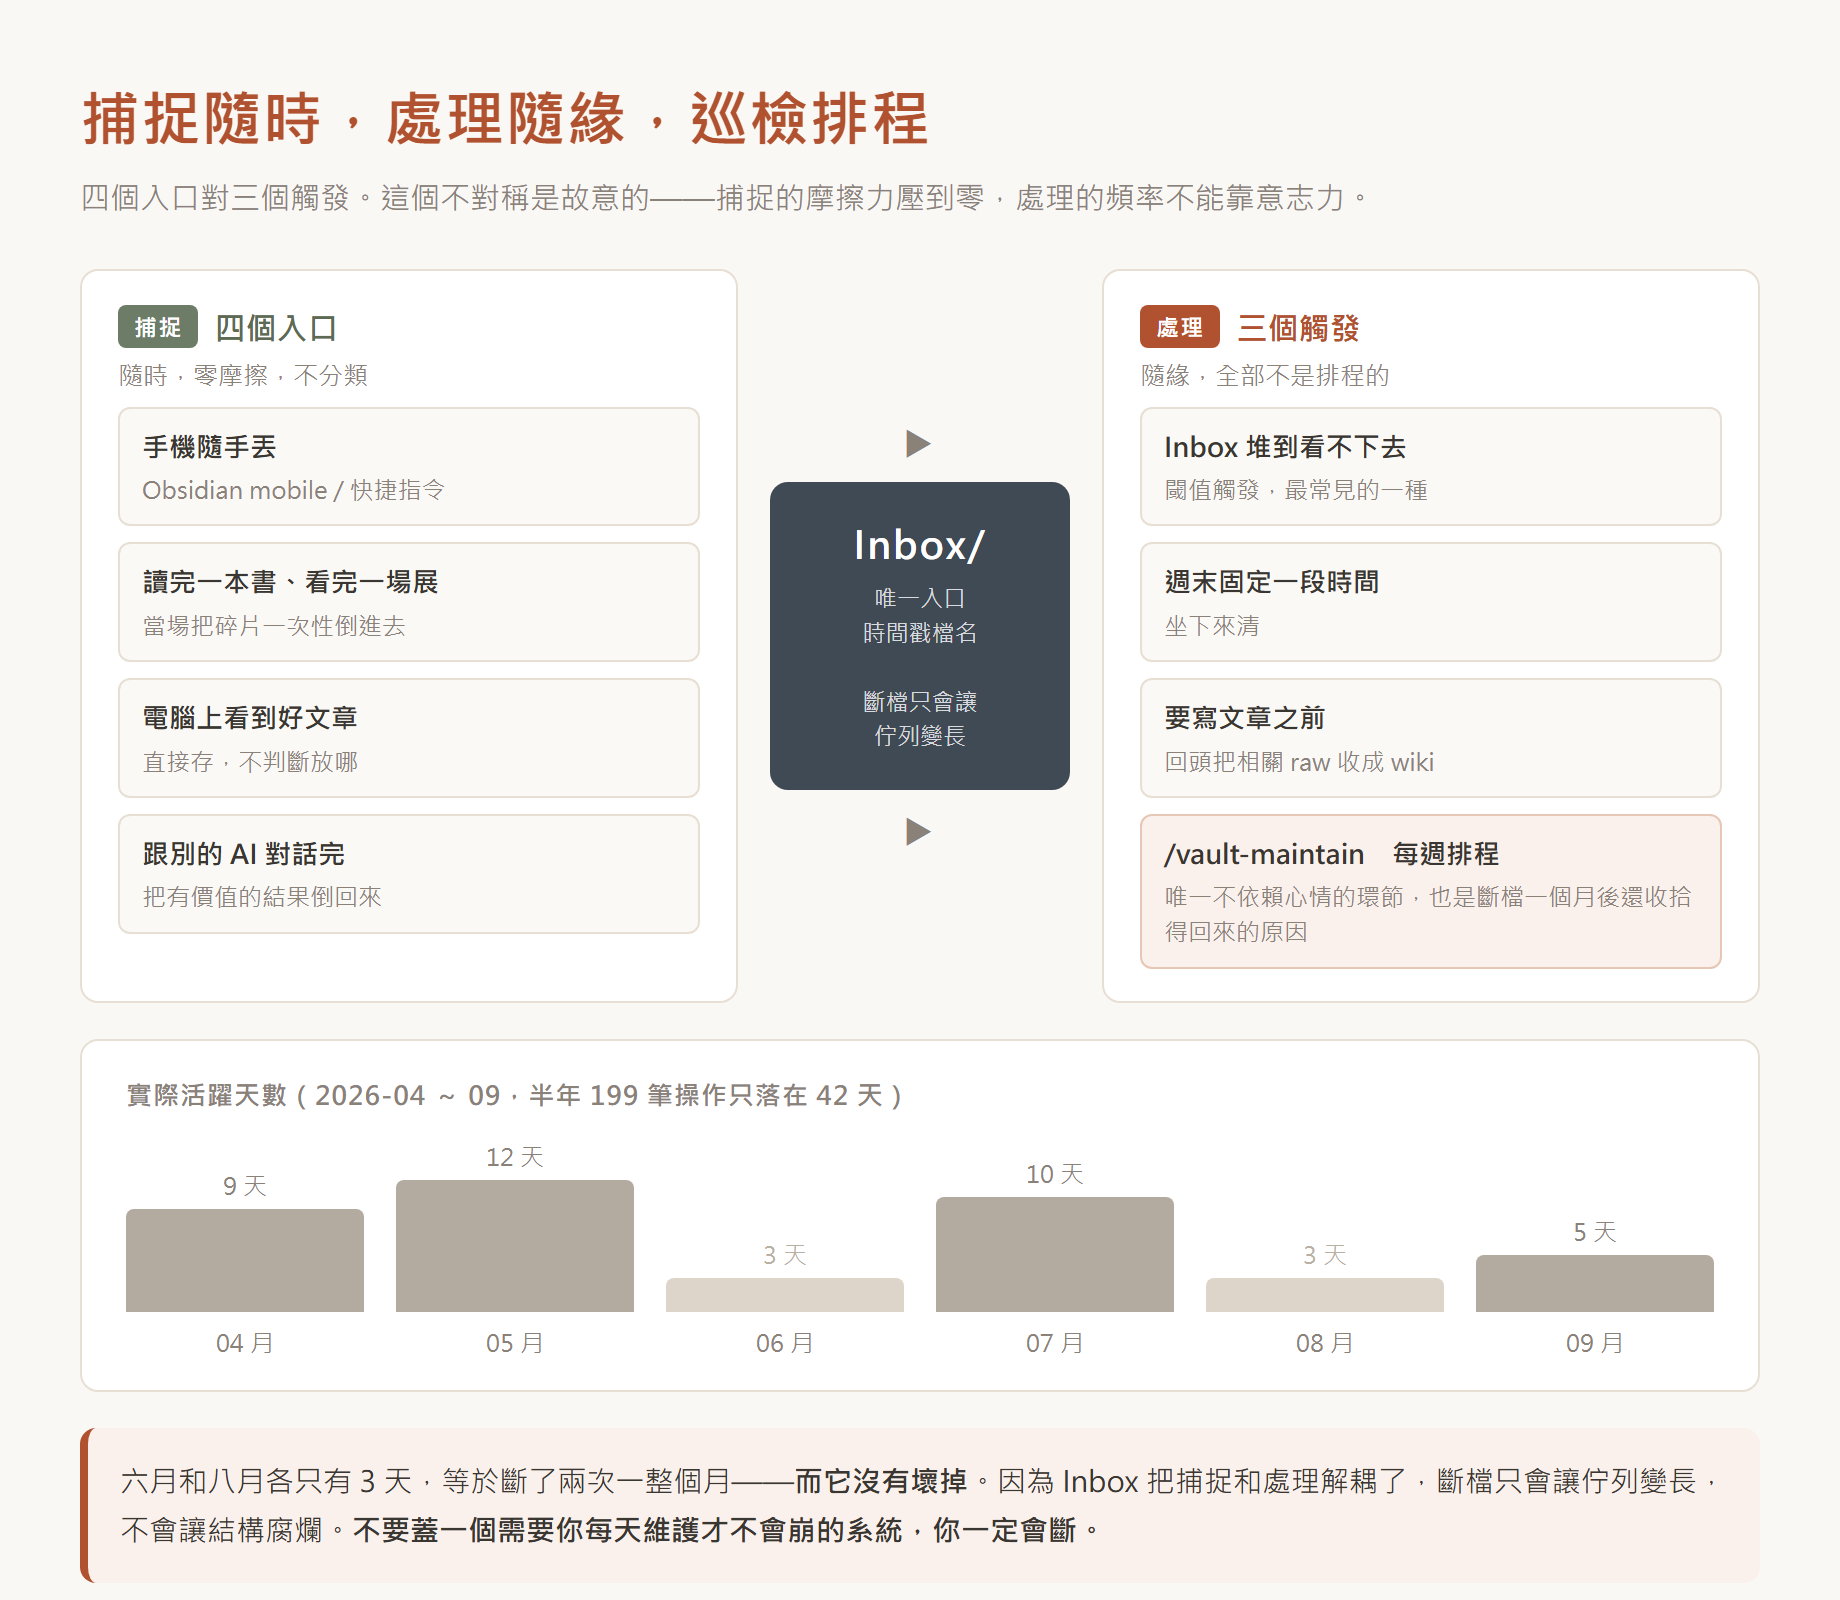
四個捕捉入口對三個處理觸發,而且捕捉是隨時、處理是隨緣——這個不對稱是故意的。捕捉的摩擦力要壓到零,處理的摩擦力可以高一點,但處理的頻率絕對不能靠意志力維持。 所以會斷的那一端(處理)要有一個排程的兜底,不會斷的那一端(捕捉)要有愈多入口愈好。
起手式 prompt:把這段複製給 AI
前面講了一大堆取捨,但取捨不能直接執行。所以這節給一段可以直接用的東西。
把下面整段複製給任何一個能操作檔案的 AI 終端機(Claude Code、Cursor、Codex 都行),它會先訪談你,再照你的答案長出屬於你的骨架。
這段 prompt 刻意不會幫你生出 15 個 skill。它只做一個,其餘的要你自己長——理由前面講過,護欄和管線都是長出來的,不是設計出來的。一次把我的 15 個複製給你,你會得到 14 個從來沒跑過的指令,外加一份你不敢改的規則檔。
你是我的知識庫建置協作者。我要照 Karpathy 的 LLM Wiki 架構,蓋一個屬於我自己
的個人知識庫(以下稱 vault)。核心理念是:整理發生在寫入時、不是查詢時,所以
這個知識庫會複利累積,而不是每次查詢都從一堆雜訊重新推導。

請照下面的順序跟我工作。

## 第一步:先訪談我,不要先動手

在建任何資料夾之前,請把下面的問題一次列出來讓我一次回答,**不要逐題問我**。
我回答完,你才開始動手。

### A. 域(頂層資料夾)
1. 你最近三個月「實際寫過筆記」的主題有哪些?請列 3–8 個。不要列你想寫但
   還沒寫過的。
2. 這些主題裡,哪些是「一筆一筆累積的紀錄」(喝過的咖啡、看過的展、投資標的)?
   哪些是「每次練習的當日體感日記」(健身、樂器、運動)?哪些兩者都不是、
   純粹是知識和想法?
3. 有沒有哪個主題你很想開,但目前只有一兩則?

### B. 捕捉習慣
4. 你想到一件事的當下,手邊最常是什麼裝置?
5. 你現在的筆記散在哪些工具裡?
6. 你一週大概會產生幾則新筆記?

### C. 產出與動機
7. 你整理這些東西最終是為了什麼?(寫文章/做決策/不想忘/教別人)
8. 有沒有需要對外輸出的格式?(部落格、投影片、社群圖卡)
9. 你希望多久之後看到第一個「它真的有用」的時刻?

### D. 語言與環境
10. 筆記主要用什麼語言?會中英混用嗎?
11. 你會在幾台機器上用它?怎麼同步?
12. 你會用 Obsidian 這類編輯器看它,還是只透過 AI?

## 第二步:照我的回答,只建最小骨架

不要一次把所有域都建出來。規則:

- 只建問題 1 裡「最近三個月真的寫過」的域,而且第一次最多建兩個
- 每個域按問題 2 的答案擇一種型態:
  - 紀錄型 → `{域}/records.md`(單檔表格追蹤)
  - 日記型 → `{域}/logs/YYYY-MM-DD.md`(每日一檔)
  - 純知識型 → 兩個都不建
  - **同一個域不准同時有 `records.md` 和 `logs/`**,它們對「一次記錄」的
    定義不同,混在一起之後誰都不知道該往哪寫
- 每個域都建 `raw/`,但**先不要建 `wiki/` 和 `index.md`**。等 `raw/` 累積到
  5 個檔再建,`wiki/` 和 `index.md` 同時建立
- 一定要建 `Inbox/`(唯一入口)和 `others/raw/`(不確定歸屬的合法停車格,
  不是垃圾桶)
- 問題 3 提到的主題一律先放 `others/raw/`,同主題聚到 5 個檔以上再升成域

## 第三步:寫第一版規則檔

在根目錄寫一份 `CLAUDE.md`(或你這個工具對應的自動載入規則檔)。**只寫這四段**:

1. **路由**:什麼東西放哪個域、哪一層。要具體到我看得懂、你下次也照得出來
2. **Domain 結構**:每個域的 layout,以及 records/logs 互斥這條
3. **寫作格式**:wiki 頁的 frontmatter 必填欄位,至少 `title` / `summary` /
   `tags` / `date`。`summary` 必填,因為域的 `index.md` 會直接吃它,格式是
   `[[頁面路徑]] — 一行摘要`。索引行寫得好不好,直接決定這頁會不會在該被
   找到的時候被找到
4. **禁止事項**:不准跳過 `raw/` 直接寫 `wiki/`(raw 是 wiki 的前置沉澱);
   同一個概念不准建兩份,要用連結引用

**不要寫「行為準則」那一段。** 我還沒看過你在我的資料上會怎麼犯錯,現在寫的
只會是從別人文章抄來的通則,而通則擋不住我自己的問題。等真的被咬過再回來補。

## 第四步:只做一個 skill

先做 `inbox-triage`:讀 `Inbox/` 的檔案,判斷域,改成有意義的檔名,搬到
`{域}/raw/` 或 `{域}/logs/`。

三條硬性要求,缺一不可:

1. **不准逐條問我。** 把所有判斷寫成一份決策檔,讓我一次看完一次改完,
   而不是被問 20 次「這個要放哪」
2. **需要後續處理的項目一律寫進根目錄 `TODO.md` 的固定區段**,不可以只在
   對話裡提一句。管線的接力棒要有實體,否則那些檔會永遠停在 raw/
3. **移檔前先改連結。** 有其他檔案連到舊檔名的話,先全庫改寫再移,
   不要有斷鏈空窗

## 第五步:給我一份「先不要做」的清單

明確告訴我接下來哪些事先不要碰,以及為什麼:

- 先不要做發布/輸出類的功能(圖卡、投影片、推到部落格)。它們的輸出不落在
  vault 裡,應該是 vault 外的獨立工具。寫在 vault 裡,之後發布端一改格式,
  我就得改 vault 裡的程式碼
- 先不要寫任何自動阻擋的 hook。等某類錯誤真的反覆發生再擋,否則會得到一堆
  從來沒觸發過的檢查
- 先不要開第三個域

## 全程請遵守這些習慣

不管做哪一步,這些是硬規則,比上面任何一步都優先:

- **行動前陳述**:動手前先說「我理解你要的是 X,我打算做 Y,確認嗎」,
  讓我在任何副作用發生之前糾正你
- **不准代替我判斷**:整理我的筆記時,不准寫我沒說過的觀點。你從外部資料或
  推論得到的東西要放在另一個段落並標記來源,經我確認才能算成我的
- **整合是擴張加去重,不是壓縮**:把多份素材合成一頁時,不要摘要成三段空話。
  資訊量只能增加,重複的才刪
- **可以數的不要用猜的**:需要數量、清單、檔案狀態時實際去讀檔或跑指令。
  憑印象給出來的數字會「看起來很合理」,而我不會想到要去驗它
- **只有你能寫入**:如果你派出平行的子任務,它們一律只讀,所有寫入回到你身上
- **宣稱完成前先驗證**:說「改好了」之前,真的重讀一次那個檔案確認
- **建新頁前先查重**:掃目標域的 `index.md` 找相近主題,有的話預設併入既有頁,
  不要新建。名稱語言不同是查重最大的盲區,中英文都要查
用完之後你會得到:一個 Inbox/、一到兩個域、一份四段的規則檔、一個 inbox-triage。
看起來很少,但這就是能跑的最小版本。剩下的 14 個 skill、四條 hook、12 條習慣裡的每一條,都應該等你撞到對應的問題之後再長出來——那時候你才知道自己要的是什麼形狀。
小結
五步起手式收在一起,就是這篇的 checklist:
- 一份 CLAUDE.md 加一個域。 只寫路由和 layout,行為準則留空——那些字要被咬過才長得出來。
- 只裝
/inbox-triage。 捕捉和分類解耦。它的產出必須落地成TODO.md的固定區段,管線的接力棒要有實體。 - 第二批照維運 → 產出 → 輸出的順序裝。 輸出組最後,因為它最容易把邊界搞糊。
- 收成管線的三條判準:單一寫入點、pull-not-push、輸出不落在 vault 裡的東西不該是 vault 的 skill。
- hook 的兩條下放準則:可機械判定、真的違反過至少一次。護欄是長出來的。
- 把 12 條使用習慣抄進每個 skill。 skill 的名字會換、數量會變,這 12 條不會。
不想從頭讀的話,直接往上捲到「起手式 prompt」那節,整段複製給你的 AI 終端機就會開始跑。它會先問你 12 個問題,再照你的答案建骨架——不是照我的。
如果只能記一句,我會選第 5 步那句:結構決定你的知識庫會不會長雜草,習慣決定裡面長出來的東西有沒有價值。 前者寫在資料夾裡,後者只能寫在 skill 裡。
還有一句是寫給擔心自己撐不住的人的:我這半年只有 42 個活躍天,中間斷過兩次一整個月。它沒壞,因為會斷的那一端有排程兜底,不會斷的那一端入口開得夠多。不要蓋一個需要你每天維護才不會崩的系統,你一定會斷。
還有一筆舊帳沒還:Day8 結尾承認擋寫入的規則有兩份獨立實作,Windows 那份至今一次都沒有真的執行過。那件事還欠著,要排進後面的某一天。
明天換題目,從 llm-wiki 回到 coffee-review。
Day3 講 art-tracking 選型的時候,coffee-review 是被拿去當對照組的——那篇標題就是「為什麼不能像 coffee-review 用 GitHub Pages + Supabase」。當時給的三個理由裡,只有第一個真的只對 art-tracking 成立(agent 寫入的去重、排程、抓海報需要伺服器端程式)。另外兩個不是:資料庫直接對外、安全全壓在 RLS 和 grant 上,漏一條 grant 就是資料外洩;還有 Supabase 免費 project 額度不夠,幾個 side project 擠在同一個 project 裡用 schema 隔開。這兩條講的根本就是 coffee-review 自己。
當對照組的時候,沒有人會回頭審對照組。明天把那筆帳算完:art-tracking 那套 Cloudflare 棧(Workers + Hono + Drizzle + D1 + R2)已經跑過一輪、坑也踩過了,明天講 coffee-review 怎麼從 GitHub Pages + Supabase 搬到同一套上面——哪些 Day3 的理由現在反過來成立,以及搬家要付什麼代價。
本文同步發表於 kiwi-walk.com:https://kiwi-walk.com/blogs/engineer/ironman-2026-day11-claude-md-and-skills/